
核心事件:LeCun 正式提出 JEPA 作为世界模型核心架构
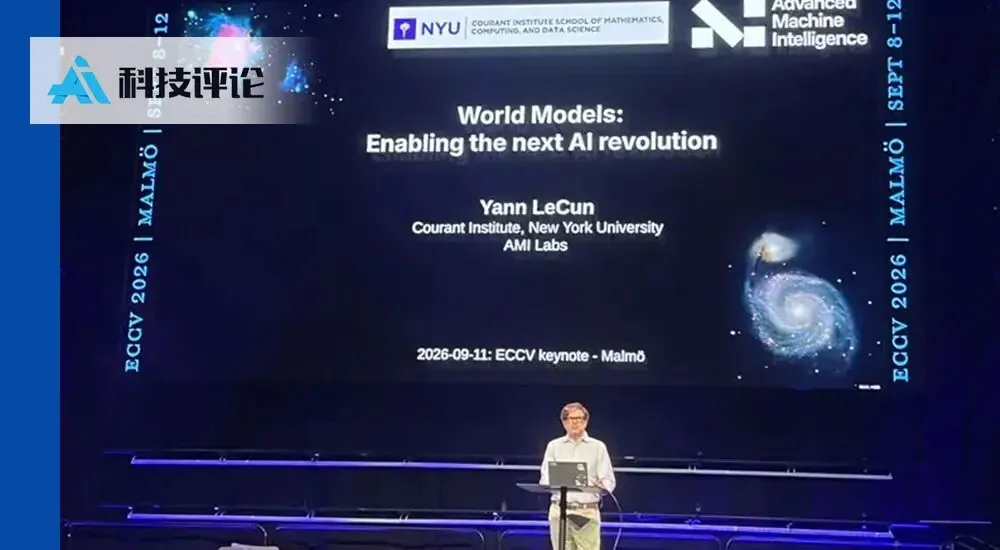
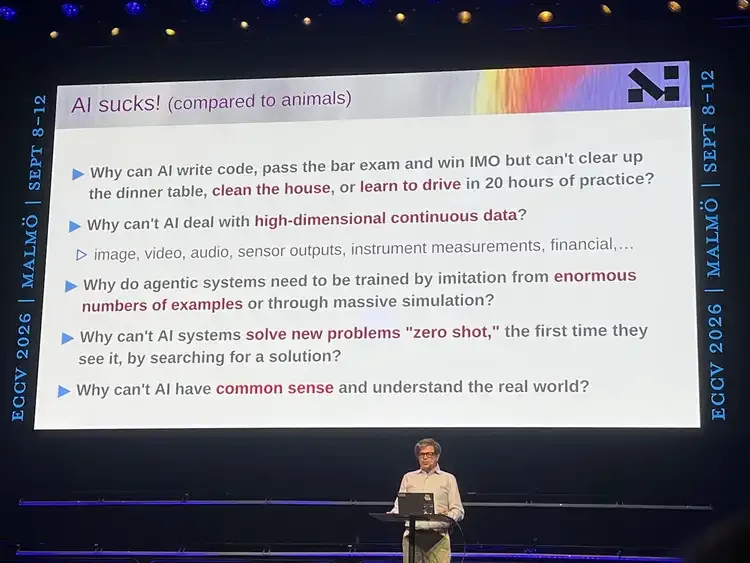
2026 年欧洲计算机视觉大会(ECCV 2026)上,图灵奖得主、深度学习三位奠基人之一 Yann LeCun 发表演讲《World Models: Enabling the next AI revolution》,系统阐释其十年来对世界模型与自主智能路径的思考。他明确否定当前主流的生成式世界模型路线,尤其批评“预测像素”为不可能完成的任务,并重申联合嵌入预测架构(JEPA)才是通往真正通用人工智能(AGI)的可行路径。LeCun 同时宣布成立 Advanced Machine Intelligence(AMI Labs)公司,加速该技术路线的工程落地。
挑战主流:为何“预测像素”不可行?
LeCun 指出,当前多数团队尝试用视频生成模型(如 Sora、Genie)构建世界模型,本质上是在像素层面预测未来。他认为该思路存在根本缺陷:摄像头捕捉的当前帧,并不包含决定下一帧内容的全部信息——例如镜头外有人走动、光线变化等外部因素,导致像素级预测任务本身无解。即使加入 VAE 或隐变量缓解模糊性,模型仍只是“凭空想象”未来,无法理解物理世界的底层规律。
他以自动驾驶为例:若训练系统预测车内摄像头下一帧画面,模型被迫学习树叶微动、水塘涟漪或行人衣物褶皱等不可控细节,这些信息对决策无关紧要,却消耗大量模型容量与训练数据,反而损害其表征能力。
JEPA 架构:在抽象空间做可规划预测
JEPA 的设计哲学是“丢掉不可预测的细节”。其工作流程是:先用编码器将原始输入(如图像帧、动作指令)映射到紧凑的表征空间,再在该空间中预测后续状态。这一变换过程天然过滤掉高维噪声与不可观测变量,使预测问题变为可解。
该架构天然适配层级化规划(Hierarchical Planning)需求。LeCun 强调:人类规划旅程不会逐毫秒规划肌肉收缩,而是在高层(如“抵达机场”)、中层(如“打车”)、底层(如“起身”)多级抽象间切换。JEPA 的表征空间支持这种分层建模:高层表征保留可规划的核心结构,低层表征负责细节执行。
关键对比:文本训练 vs 视觉-物理经验
LeCun 通过信息量对比揭示当前范式的先天不足:
- 大语言模型典型预训练数据约 30 万亿 token(约 10¹⁴ 字节),相当于人类需 40 万年读完
- 一个四岁儿童通过视觉与触觉接收的信息量已达约 10¹⁴ 字节(视网膜后约 200 万根视神经纤维 × 每秒 1 字节 × 6 万小时清醒时间)
这意味着仅靠文本数据的模型,其学习信息上限远低于人类婴儿。他特别强调:计算机视觉研究者最清楚物理世界比文本更“脏”、连续且高维,这也是大语言模型部署到真实世界时漏洞百出的根本原因。
落地建议
- 适合探索者:对世界模型、具身智能、机器人决策规划感兴趣的研究团队,可重点关注 JEPA 在表征不变性设计与分层优化方面的实现细节
- 建议再等等:期待端到端自动驾驶或家庭服务机器人的落地应用者,应理性看待当前技术成熟度——LeCun 自认 L5 自动驾驶尚未解决,行业仍需显式物理引擎与工程化世界模型的阶段性方案
写在最后
LeCun 的演讲实质是针对 AI 发展路径的一次路线重估。他将“生成式”熟能生巧的陈述性知识与“推断式”即兴解决新问题的能力明确区分开来,后者才是智能的本质。若 JEPA 路线得以验证,未来数年智能体将从“像素拟合者”转向“物理规律推理者”,其影响或将重塑整个具身智能研发范式。