
新版本发布与关键事实一览
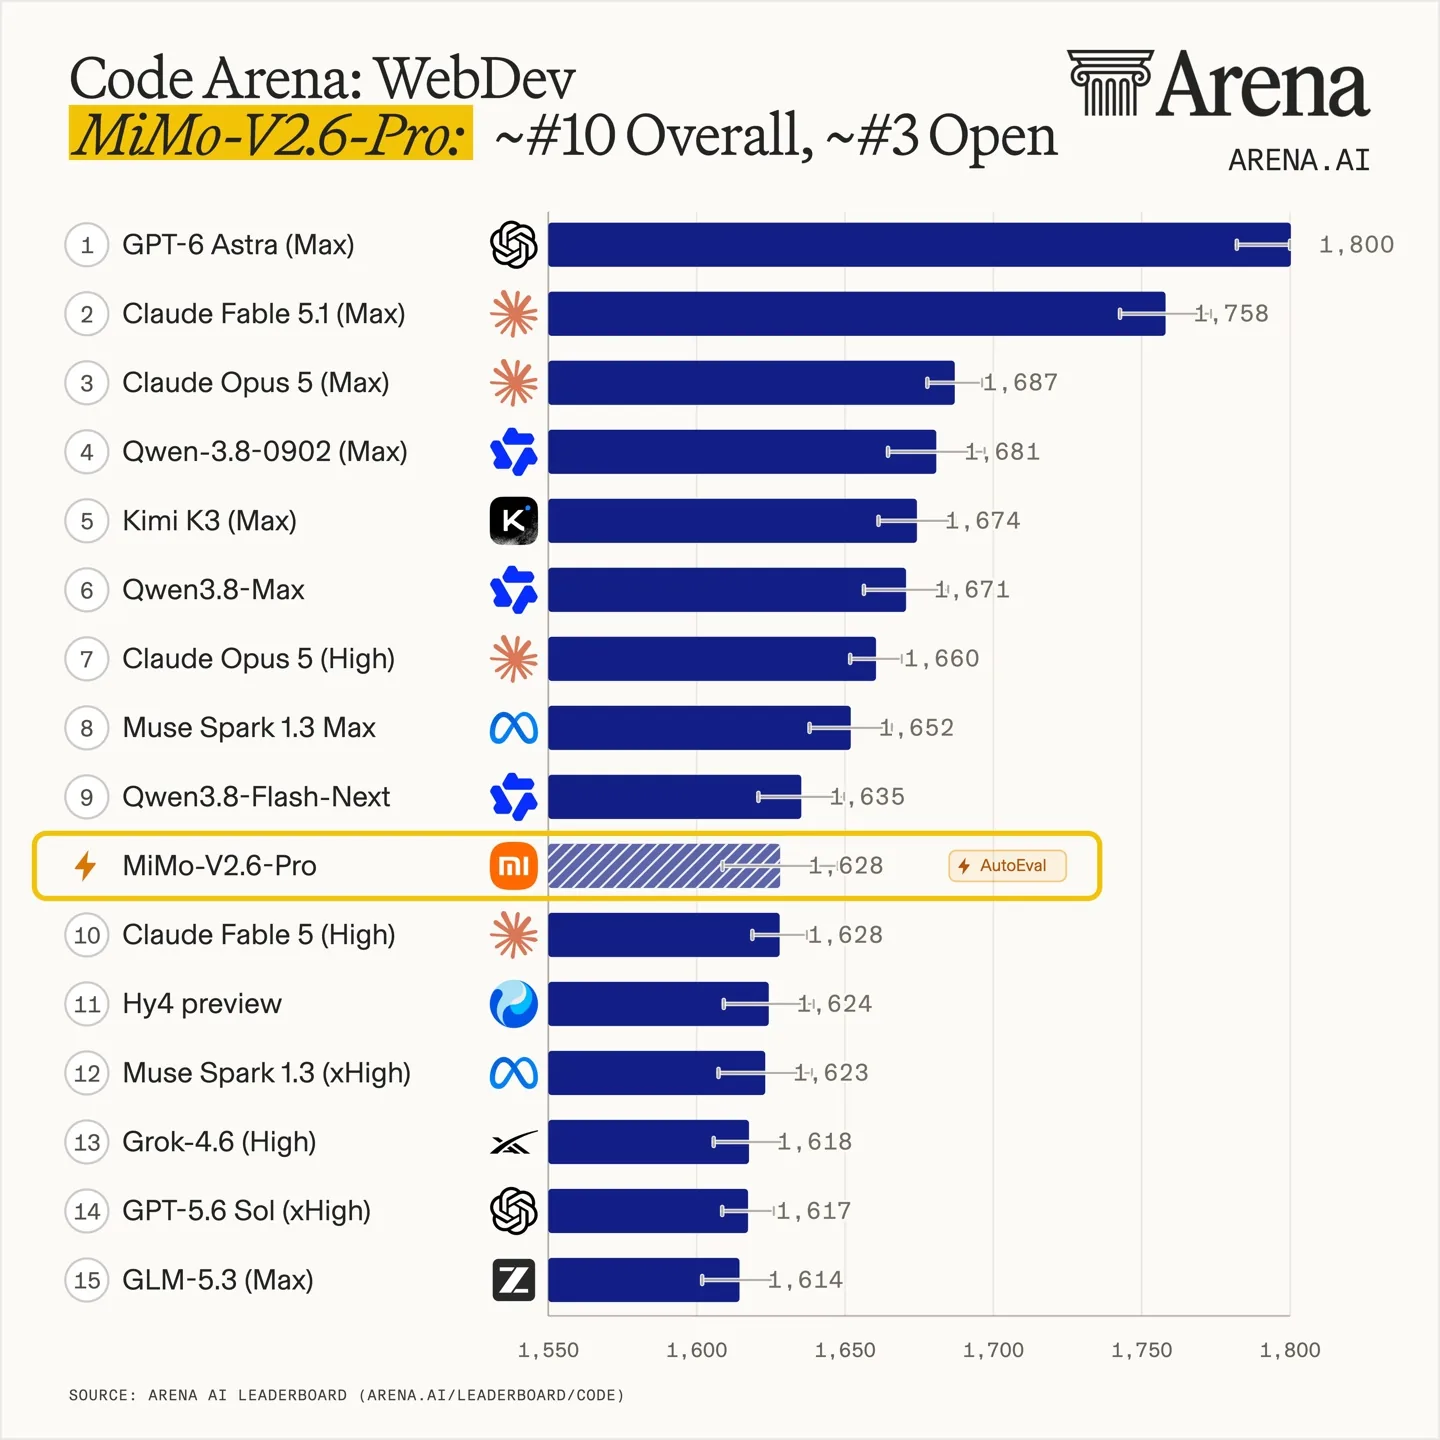
小米MiMo团队于9月22日深夜正式发布并开源MiMo-V2.6系列,同时公布MiMo-V3将采用全新架构的信息。核心Highlights如下:
- 发布时间:2026年9月22日深夜(公开时间为9月23日)
- 新版本:MiMo-V2.6-Pro 与 MiMo-V2.6-Flash,以及MiMo-V2.6-Distill-Qwen-9B
- 即将发布:MiMo-V3,将采用HySparse 2核心架构
- 价格策略:Flash模型每百万词元输入1元、输出2元;Pro模型为输入3元、输出6元;支持99%缓存折扣
- 何时可用:MiMo-V2.6系列已上线小米MiMo开放平台;MiMo-V3尚未开放具体上线时间
- 权重开放:MiMo-V2.6-Pro、Flash模型权重及全部技术报告已全面开源
来自RL训练的突破性数据
MiMo-V2.6系列是小米探索递归自我改进(RSI)路径的关键一步,其最大突破在于RL(强化学习)训练阶段的算力投入与效率提升:
- 单次更新使用1568个样本,支持100万上下文长度训练,单步训练Token达3.5至3.7B
- 训练历时不到6天,成本分别约262万美元(Pro)与85万美元(Flash)
- 两个模型累计完成约75万条训练轨迹
- 训练任务平均通过率分别相对提升25%(Pro)和12%(Flash)
在智能体能力方面,模型在三个维度扩展RL算力:更大的Batch与更高吞吐、更多任务与复杂环境、更大的Grader算力。训练体系覆盖Code、General、Visual、Cyber等方向,提供更精准的奖励信号。
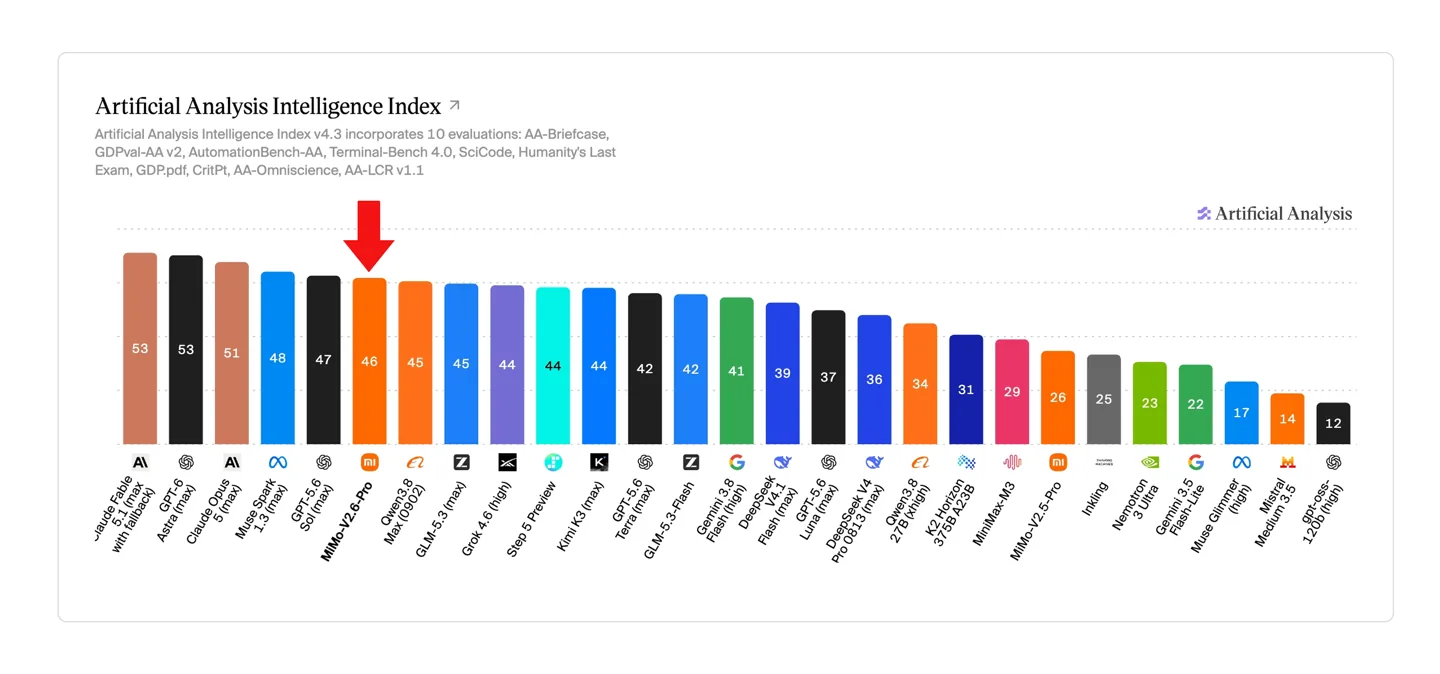
一个出人意料的反差在于:尽管Pro模型在AA综合智能指数v4.3.2中取得46分、成为当前开源模型中最高,但距离闭源头部模型(如Claude Fable 5.1和GPT-6 Astra的53分)仍有差距。更值得关注的是,MiMo-V2.6系列(未接受Lean专项后训练的版本)协助研究人员在Lean 4中完成了Li-Yorke《周期三蕴含混沌》原始主定理的完整形式化证明,形成6000余行通过Lean内核实验证通过的源码,展现了通用推理向专业形式化验证领域的跨域能力。
模型能力对比与app落地版本
| 特性 | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| AA v4.3.2分数 | 46 | 未披露 |
| 训练成本 | ~262万美元 | ~85万美元 |
| DeepSWE v1.1提升 | +17分(48.8→65.7) | +14分(58.4→72.6) |
| 单步训练Token | 3.5-3.7B | 3.5-3.7B |
| SWE-bench Verified | 61.1→66.2 | 未披露 |
| API定价($/M) | 3/6 | 1/2 |
MiMo Desktop桌面客户端同步上线,支持Windows与Mac系统,内置UltraSpeed超高速模式,最高提供20倍推理速度提升。订阅会员可直接使用Pro与Flash模型,也可通过API Key配置使用。
开源贡献与科研成果
小米同步开源三大核心资产:
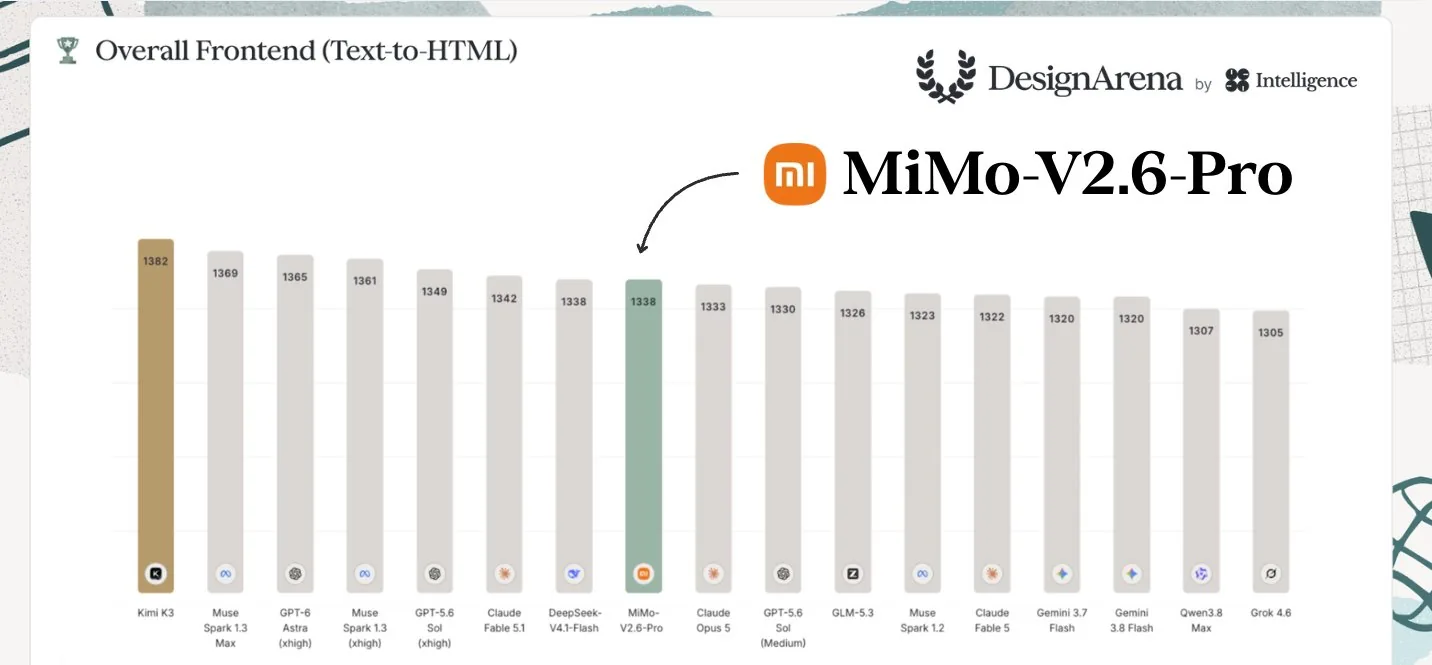
- 7k+高质量RL任务环境:覆盖软件工程、漏洞复现、知识型工作、网页设计开发四类智能体任务
- 端到端RL训练框架:基于verl、uni-agent与mini-swe-agent,支持完整训练流程
- 轻量可组合的Harness:开源极简mini-harnesses,通过Multi-Harness Training提升泛化能力
在科研落地层面,模型已协助完成金属有机框架(MOF)材料设计方案筛选,并在Lean 4中完成了Li-Yorke《周期三蕴含混沌》原始主定理的完整形式化证明,形成6000余行通过Lean内核实验证通过的源码。
落地使用建议
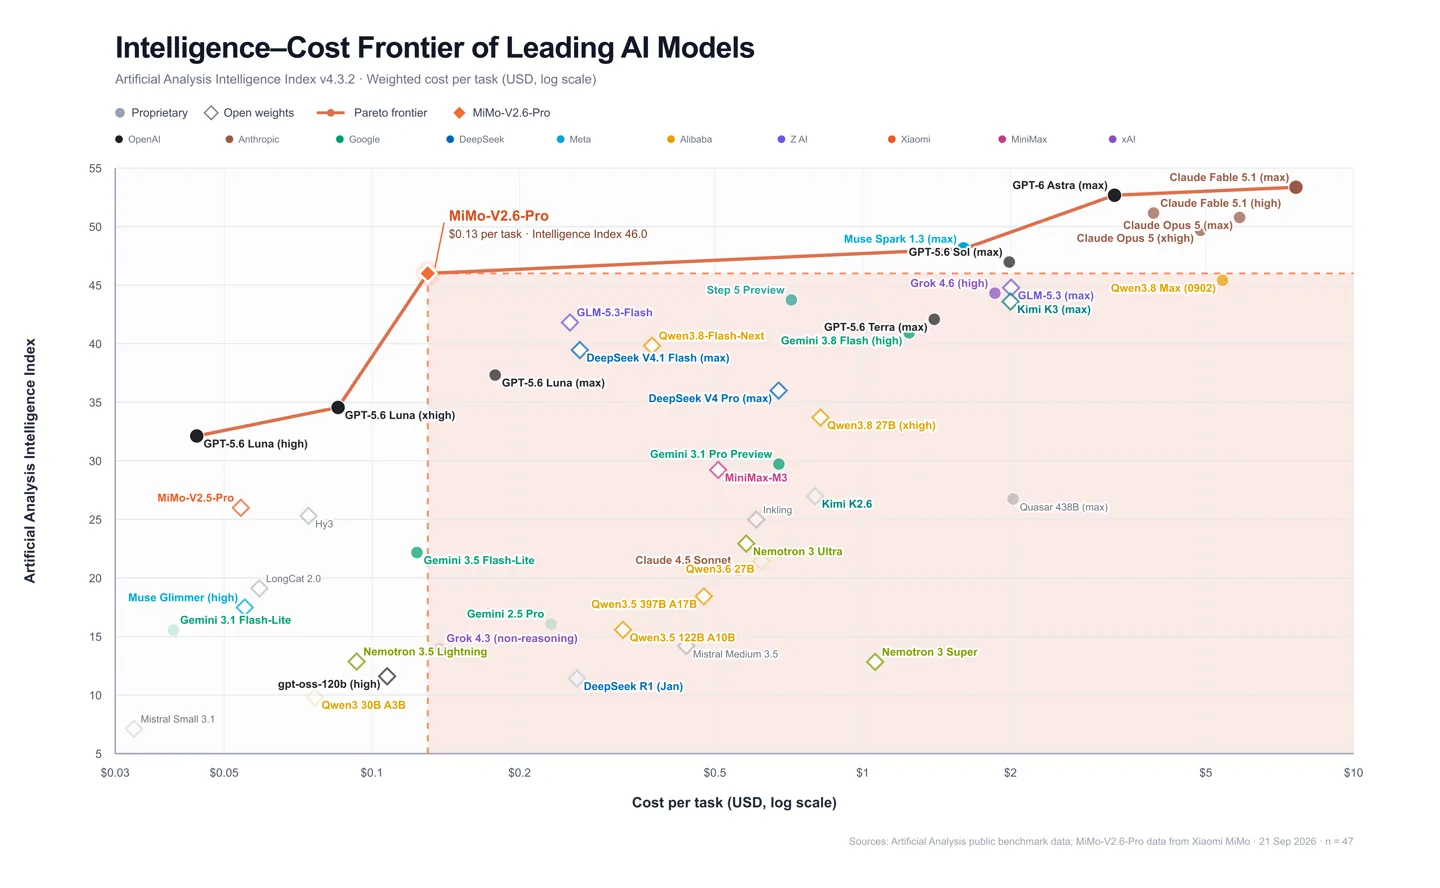
- 适合立即尝试的用户:需要处理长上下文(1M Token)任务的企业与研究者;希望低成本接入大模型API的开发者;对RL训练流程、多智能体框架感兴趣的开源社区参与者
- 建议再等等的用户:对纯闭源场景、极致低延迟有硬性要求的生产系应用;对AA指数53+分有明确需求且无法接受开源权重的商业产品方(可等待V3正式发布)
写在最后
小米此次将100万上下文、1568样本Batch的RL训练实践完整开源,为中文社区提供了难得的可复现工业化级大模型强化学习基础设施。开源权重与高性价比API的组合,有望推动国产模型在智能体与长文本领域建立新的技术平权基准。