
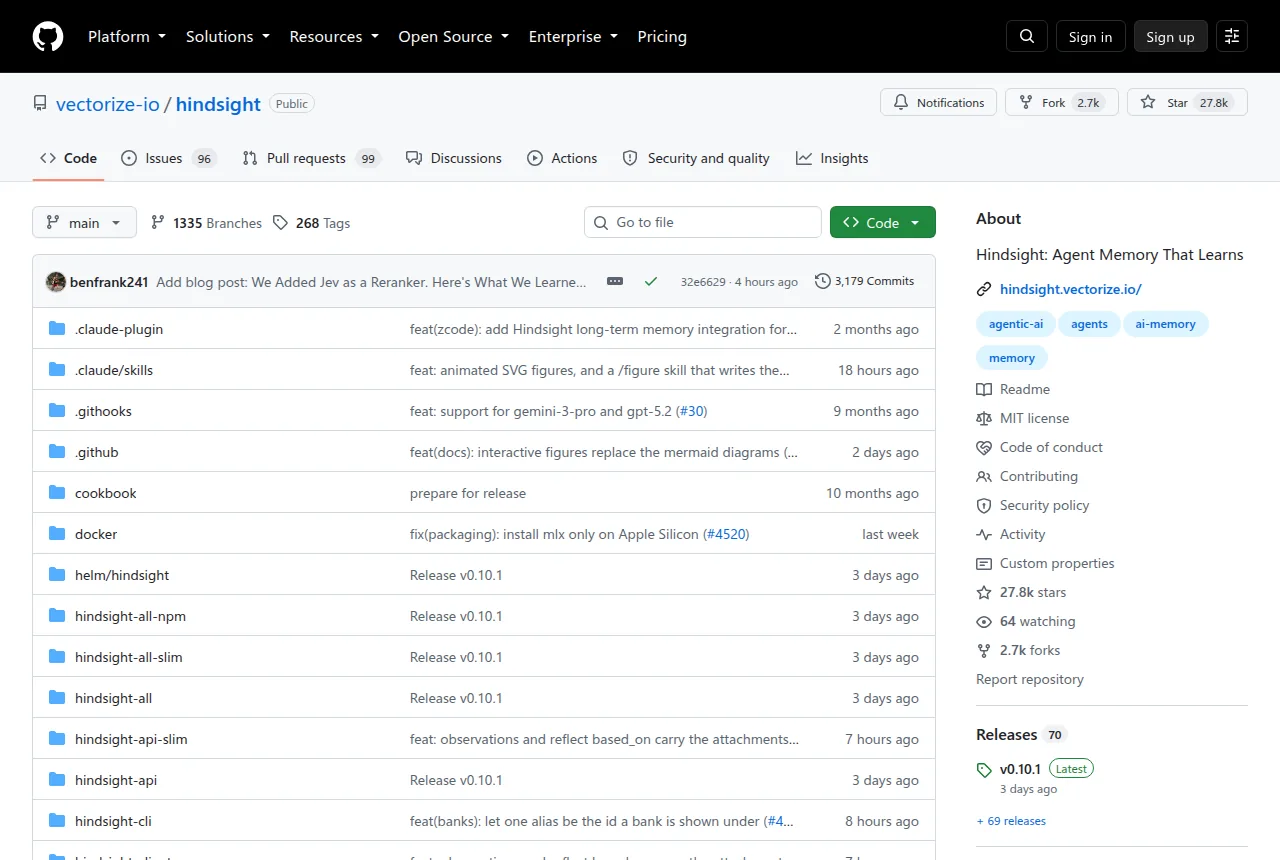
GitHub 今日 trending 榜单上,一个名为 Hindsight 的 AI 记忆系统悄然冲上榜首。它不是又一个向量数据库,而是尝试解决大语言模型最根本的短命问题——让 AI 记住的不只是对话历史,而是真正"学会"东西。
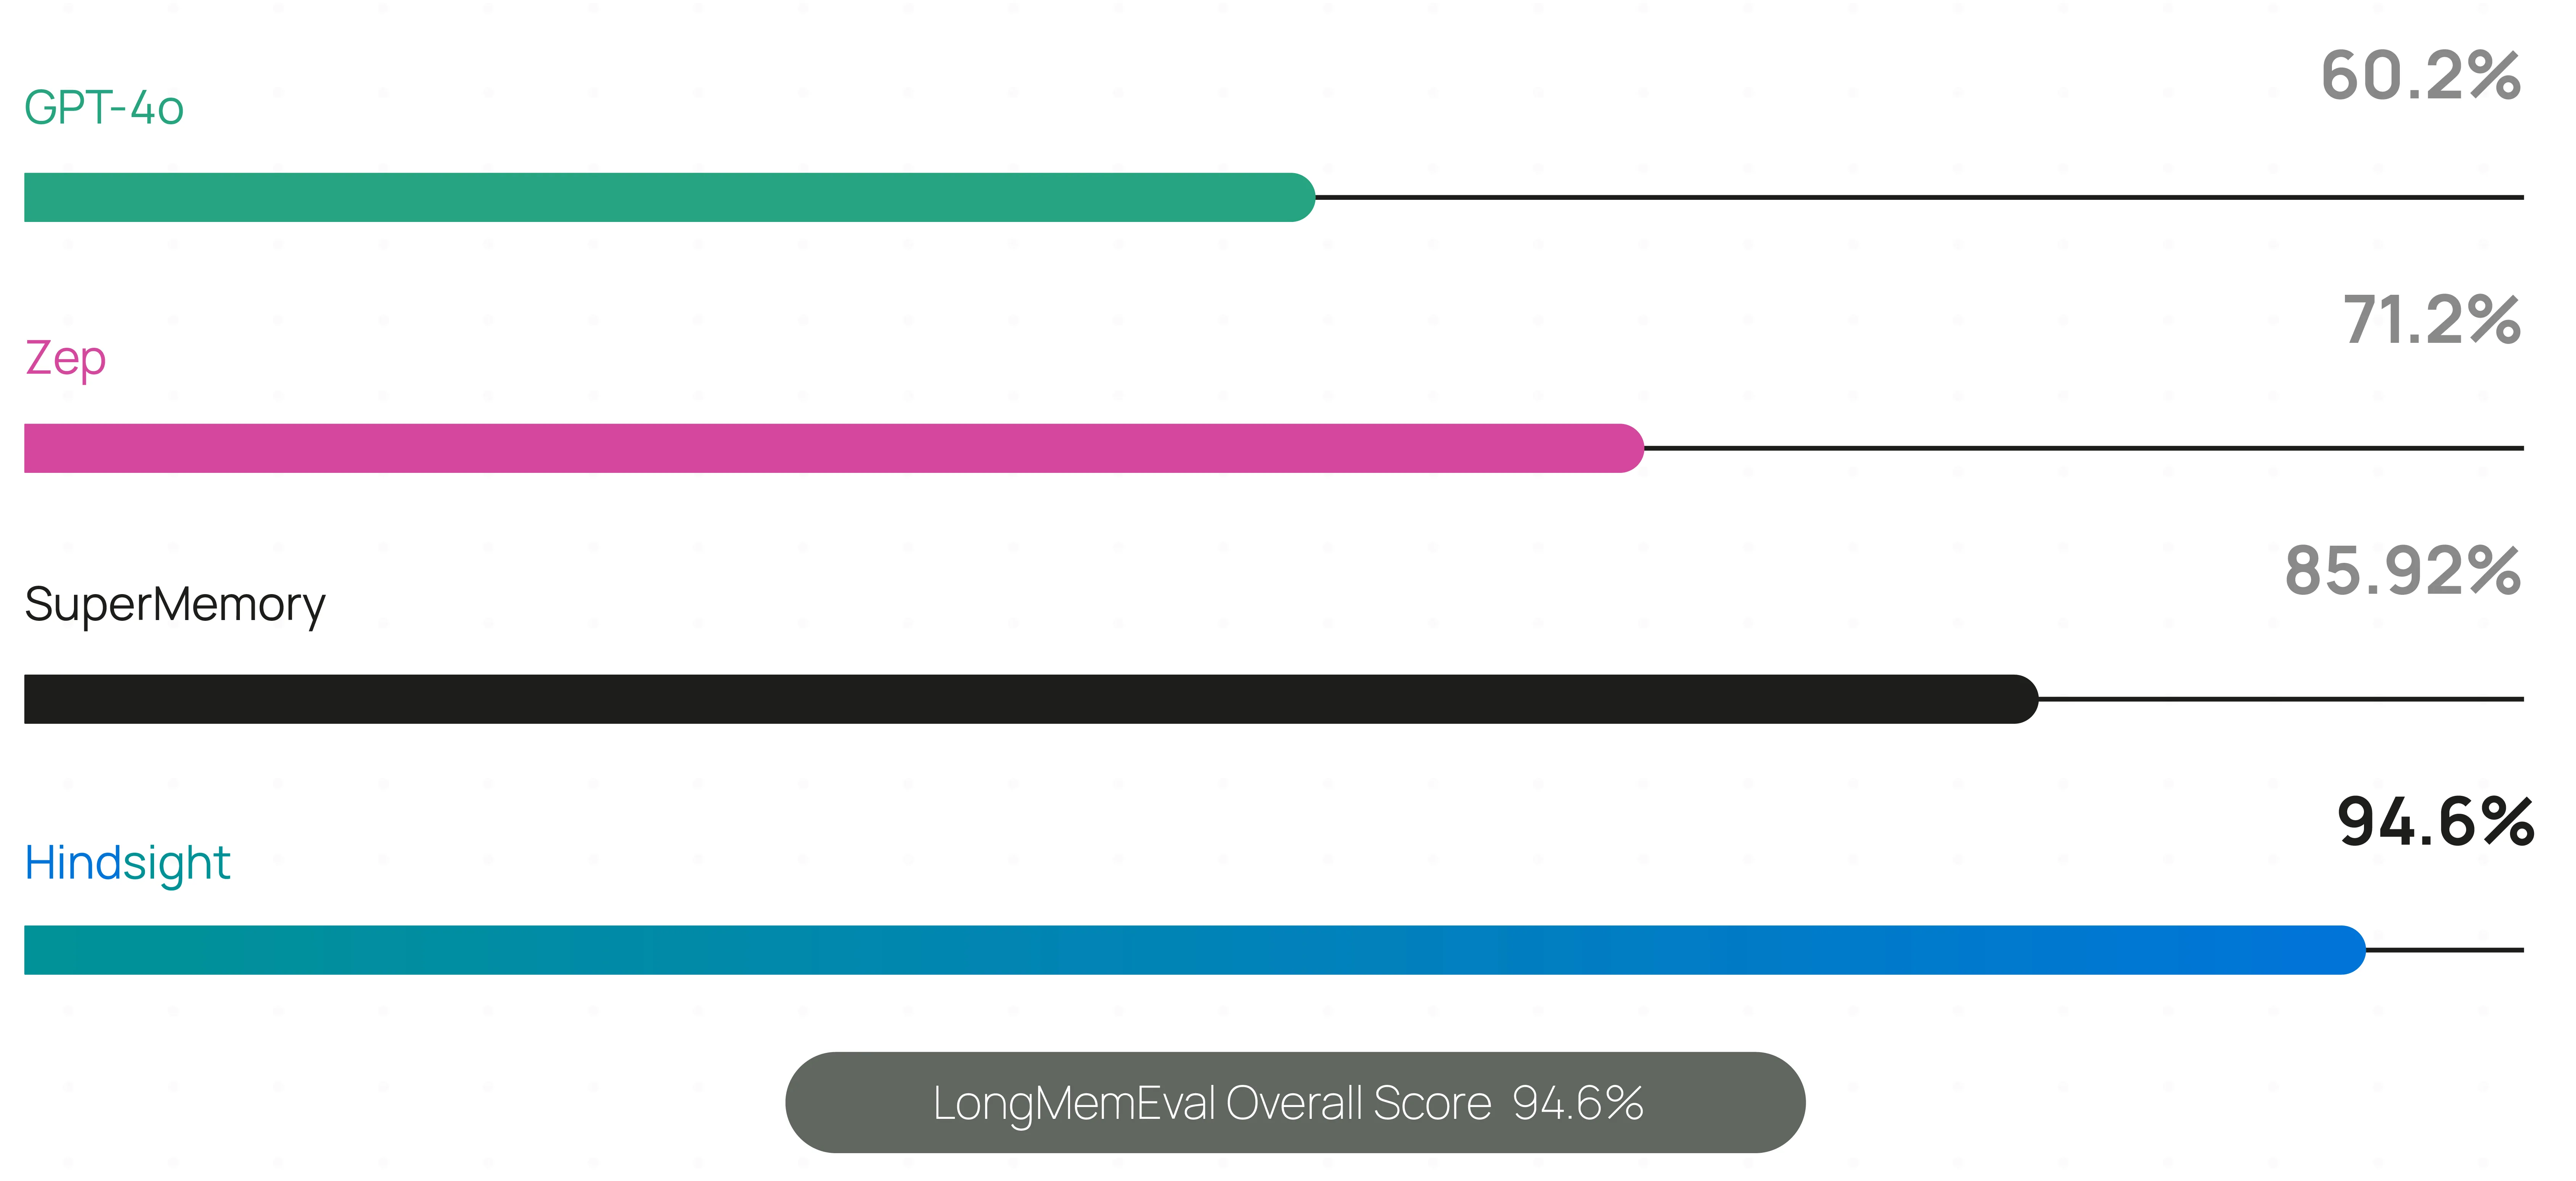
据 README 显示,这个项目在今日新增了 1668 颗星,累计 27808 星。项目宣称在 LongMemEval 长时记忆基准测试中达到当前最优性能,多家机构已独立复现其结果。如果你厌倦了每次重启就要重新教会 ChatGPT 你的企业知识,那么 Hindsight 可能提供了另一种解法。
核心功能:三种记忆操作
Hindsight 摒弃了传统 RAG 的"检索+注入"模式,提出更接近人类认知的三步操作:
- Retain(保留): 存储观察到的信息,但不急着向量化
- Recall(回忆): 根据问题动态检索相关记忆
- Reflect(反思): 结合现有知识生成Disposition-aware响应
这种设计允许系统在长期任务中保持一致性。比如你知道"Alice 在 Google 做软件工程师",当几天后问"Alice 的职业",系统不是重新搜索,而是调用之前构建的 Mental Model(心理模型),把 Alice 归类为"工程师"这个类别下。
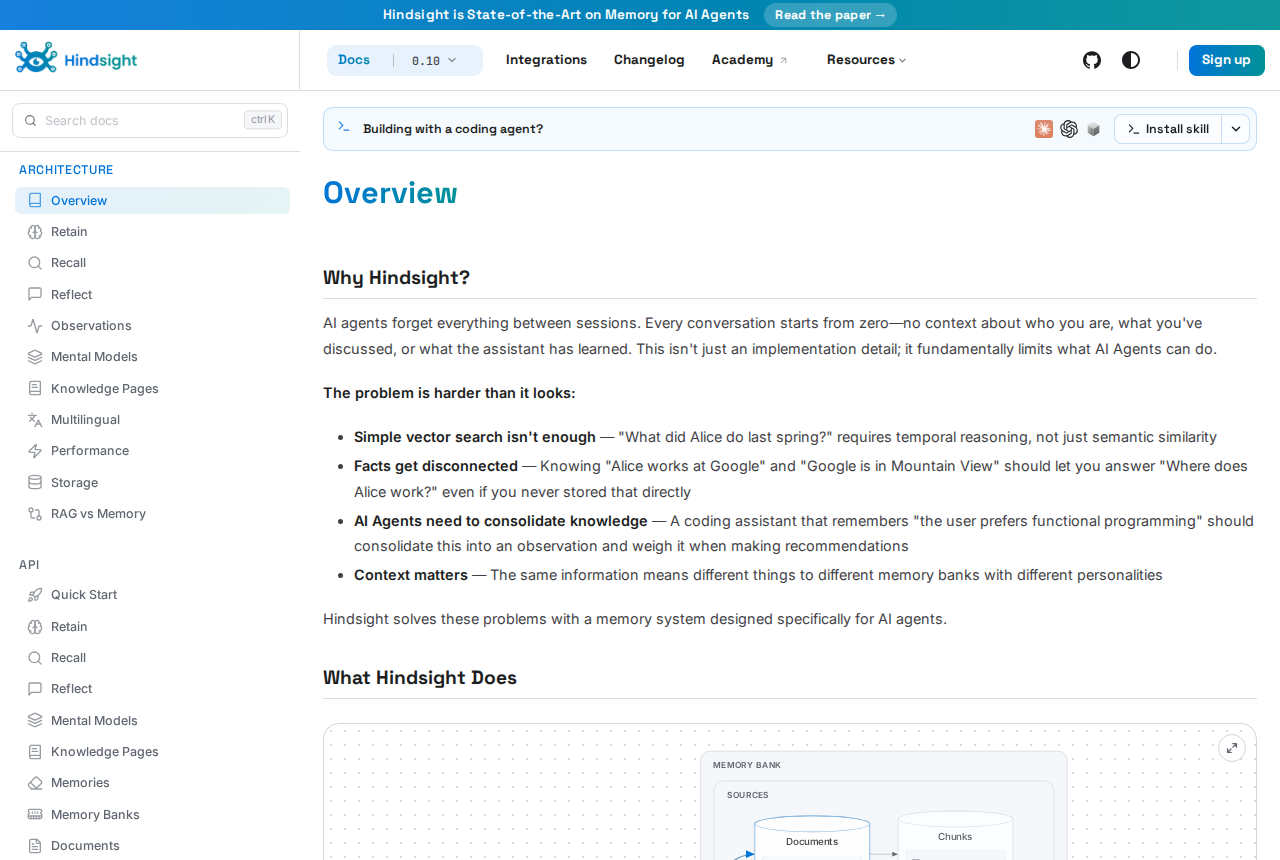
官网提供的示意图展示了典型的工作流——用户通过简单 API 传输记忆片段,系统自动构建知识页面,问答时组合所有相关线索生成连贯回答。
五分钟上手
安装分两种路径。生产部署推荐 Docker(摄:
| |
启动后,Docker 端口 9999 提供可视化 UI,8888 是 REST API 服务。无服务需求的开发者可以直接用 Python 内嵌模式:
| |
代码行数不过十行,就能让本地运行的 AI 记住关键信息。Hindsight 支持 25+ 种 LLM 提供商,包括 OpenAI、Anthropic、Gemini、Groq,以及本地化的 Ollama、LM Studio 等。如果是 GitHub Copilot 或 Claude Pro 用户,甚至无需提供 API Key。图片:官网演示界面
技术亮点与设计取舍
Hindsight 最值得玩味的是它的记忆存储策略。传统向量数据库把文本切块后向量化入库,查询时近似最近邻匹配。这种方式导致三个顽疾:冗余存储、语义漂移、无法关联。
Hindsight 采用 pg0 内嵌数据库作为底层存储,这是一个轻量级 PostgreSQL 变体。关键创新在于** Mental Model 层**——系统不只存原始句子,还会自动提取实体、关系、类别,构建可迭代的知识图谱。比如训练多次后,系统会理解"软件工程师"属于"工程师"这一上位概念,下次遇到新工程师类型可以自然泛化。
这种设计带来明显优势:
- 存储效率提升,重复知识只存一份
- 避免 RAG 的提示词污染问题
- 支持长期增量学习而非快闪记忆
但代价是引入了额外的抽象层。开发者需要理解 retain/recall/reflect 的运行机制,不如直接拼接 prompt 来得直白。此外系统依赖 LLM 做元认知处理,对于离线或低配环境有一定算力要求。
适配人群与同类对比
Hindsight 适合这三类用户:
- 企业知识库构建者: 需要长期维护客户资料、产品文档,避免每次对话都要重新喂数据
- Multi-agent 系统搭建者: 多个 AI 协作时需要共享上下文,传统会话历史难以跨代理维持
- 研究对比者: 对 LongMemEval 基准测试感兴趣,想亲自验证记忆系统效果
प्रतिद्वंद्वी项目方面,主流选择各有利弊:
- LlamaIndex / LangChain 记忆模块:灵活但需自行设计检索策略,长期一致性靠后端维护
- Anthropic 的记忆实验:闭源,仅限其平台生态
- LangChain Memory:会话级历史,缺乏知识抽象能力
Hindsight 的优势在于把记忆视为一等公民而非附属功能,从架构层面支持增量学习。其开源许可为 MIT,意味着可以自由用于商业产品。
写在最后
Hindsight 的出现标志着 AI 工程从" Prompt 工程"向"记忆工程"的演进。当模型本身越来越强,如何组织和维护知识成为新的瓶颈。这个项目是否能成为 Agent 架构的基石,仍有待社区检验。
开源地址在 GitHub,文档站点提供了完整指引与案例。如果你想让 AI 记住的不只是上下文,而是真正"学会"东西,不妨试试它的缓存机制。