
平头哥全栈AI算力集群正式发布
- 发布时间:2026年9月22日于杭州云栖大会主论坛发布
- 新版本:真武V900(新一代训推一体AI芯片)、ICN Switch互联芯片、磐脉智能网卡、镇岳SSD主控、倚天CPU路线图
- 上市时间:V900预计2027年Q1量产销售;2028年Q3将推出真武J900
- 权重开放:未提及是否开放权重,仅说明SAIL软件栈已覆盖260+主流框架
- 适用场景:大模型训练与推理、具身智能、自动驾驶、金融、能源制造等
真武V900:性能跃升显存翻倍,支持万亿参数模型部署
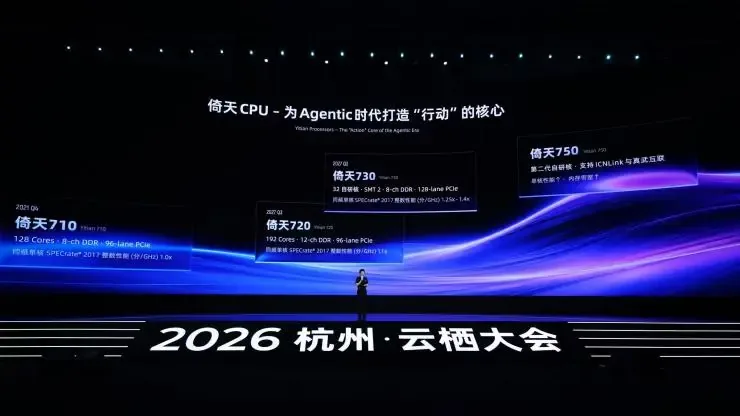
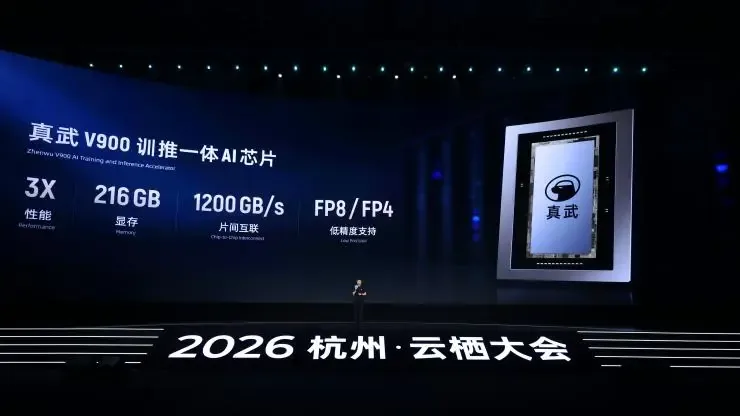
平头哥最新一代AI芯片真武V900在单芯片性能、显存容量与互联带宽上实现三重突破。单芯片性能达到上一代真武M890的3倍,搭载216GB显存(较M890的144GB提升50%),片间互联带宽从800GB/s提升至1200GB/s。该芯片原生支持FP8与FP4精度,覆盖高精度训练到低精度推理全场景。
依靠216GB大显存,仅需10余颗V900即可部署万亿参数规模的大模型。基于M890的超节点已跑通Qwen3.8与Kimi K3等超2万亿参数模型。关键反差点在于:当模型参数扩展至数万亿规模时,单芯片显存仍显不足,必须分布式部署——此时芯片间通信速度成为决定专家并行效率的核心瓶颈,而非单纯compute性能。
算存网全栈协同:从芯片到服务器系统级优化
V900并非孤立存在,其效能最大化依赖平头哥构建的全栈生态:
- 真武V900:执行AI计算核心任务
- ICN Switch互联芯片:实现千卡全带宽高速互联,具备原生内存语义与统一编址能力
- 磐脉智能网卡:连接服务器与数据中心网络,加速模型数据流动
- 镇岳SSD主控:提升本地存储吞吐效率
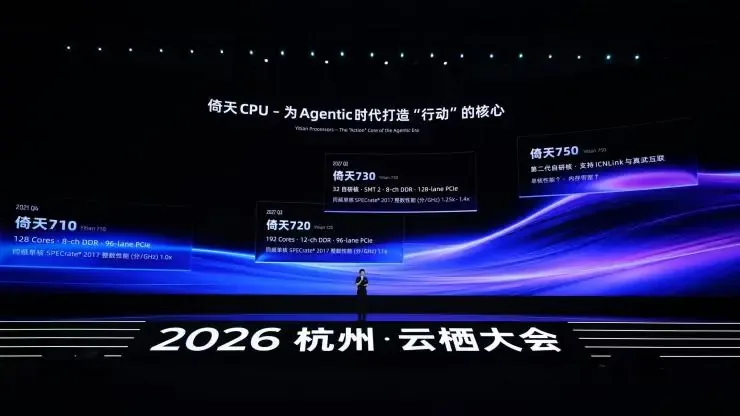
- 倚天CPU路线图:2027年推出190核的倚天720(面向吞吐并发型)与首款高性能核倚天730(支持双路同步、单核性能达前代1.4倍),特别针对Agentic负载中CPU需持续处理外部工具调用的需求
在Agentic场景下,CPU与AI芯片的协作权重显著提升。Intel在本届Computex上公布数据显示,传统训练中CPU:GPU比例约为1:8,而Agentic负载正向1:1演进。
硬件+软件双轮驱动:SAIL栈加速模型落地
软件层面,SAIL栈已覆盖操作系统、SDK及接口层,并提供驱动与调试工具。其成效体现在实际模型适配上:Kimi K3基于M890的软件优化中,首Token时延下降35%,单卡解码吞吐提升1.8倍。当前SAIL已适配260+主流框架,覆盖Github上15218个超1亿star的AI项目,主流推理框架(vLLM/SGLang)平均1周内完成全量适配。
阿里云灵骏真武超节点实例在Agentic推理场景中实现最高1.5倍性能提升,验证了从芯片到云平台的全链路协同价值。
| 芯片版本 | 显存容量 | 片间互联带宽 | 性能对比(较前代) | 发布时间 |
|---|---|---|---|---|
| 真武810E | 未公布 | — | — | 2024年 |
| 真武M890 | 144GB | 800GB/s | 3倍于810E | 2026年5月 |
| 真武V900 | 216GB | 1200GB/s | 3倍于M890 | 2026年9月(量产2027Q1) |
| 真武J900 | 未公布 | 未公布 | 未公布 | 预计2028Q3 |
落地建议与适用人群
- 适合立即采用:需部署万亿参数MoE模型的企业,尤其是具身智能、自动驾驶等对训练效率与集群稳定性有高要求的场景。已采用真武M890的客户(如众擎机器人、小鹏汽车)可观察V900带来的性能跃迁效应。
- 建议再等等:仅需中小规模推理的团队可等待V900量产定价与生态成熟度;纯推理负载未启用Agent工作流的企业,当前M890+现有推理框架组合仍具性价比。
写在最后
AI硬件正从单一芯片性能竞赛转向系统级协同效率比拼。阿里凭借模型、芯片、云平台的闭环验证能力,在预判摩尔定律放缓后的‘后摩尔时代’算力路径上,走出了一条软硬协同的新范式。