核心事件:超节点与megakernel同时破局万亿模型推理
2026年9月下旬,海内外团队几乎同步释出针对最大开源模型Kimi K3的推理优化方案,标志大模型效率竞争进入系统层深水区:
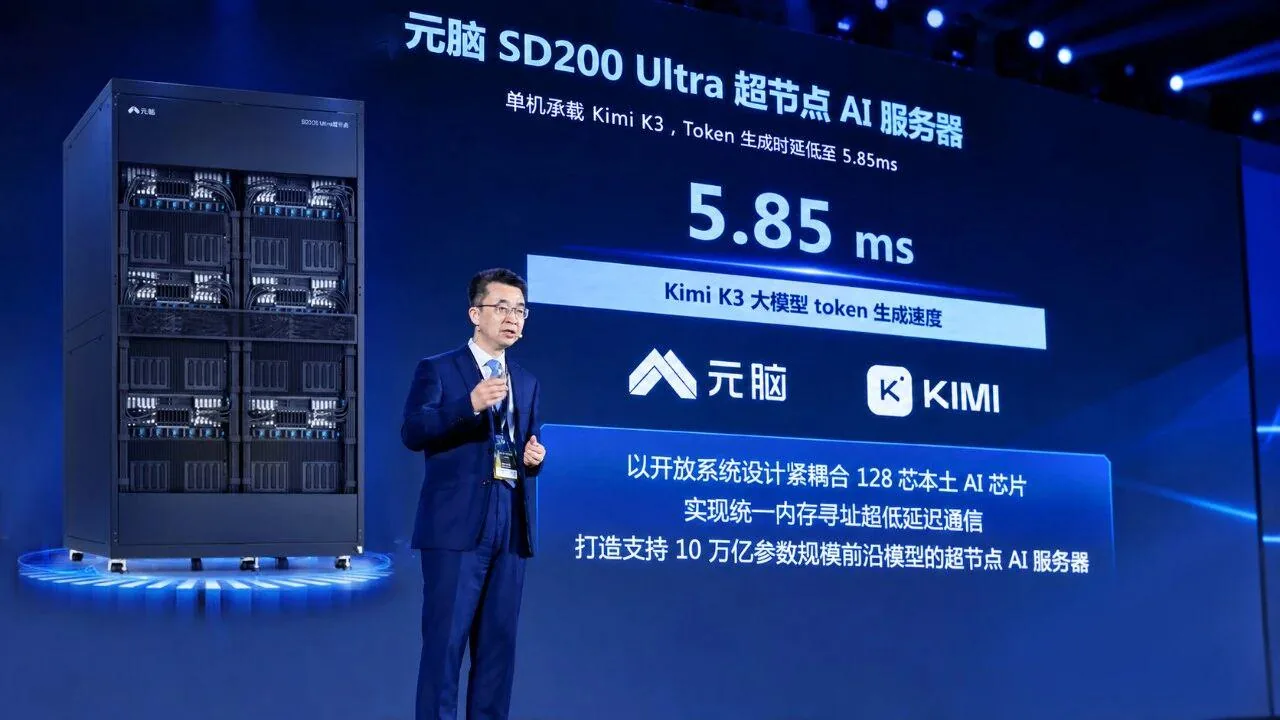
- 2026年9月21日:浪潮信息发布元脑SD200 Ultra超节点AI服务器,单机承载2.8万亿参数Kimi K3,Token生成时延首破5.85毫秒
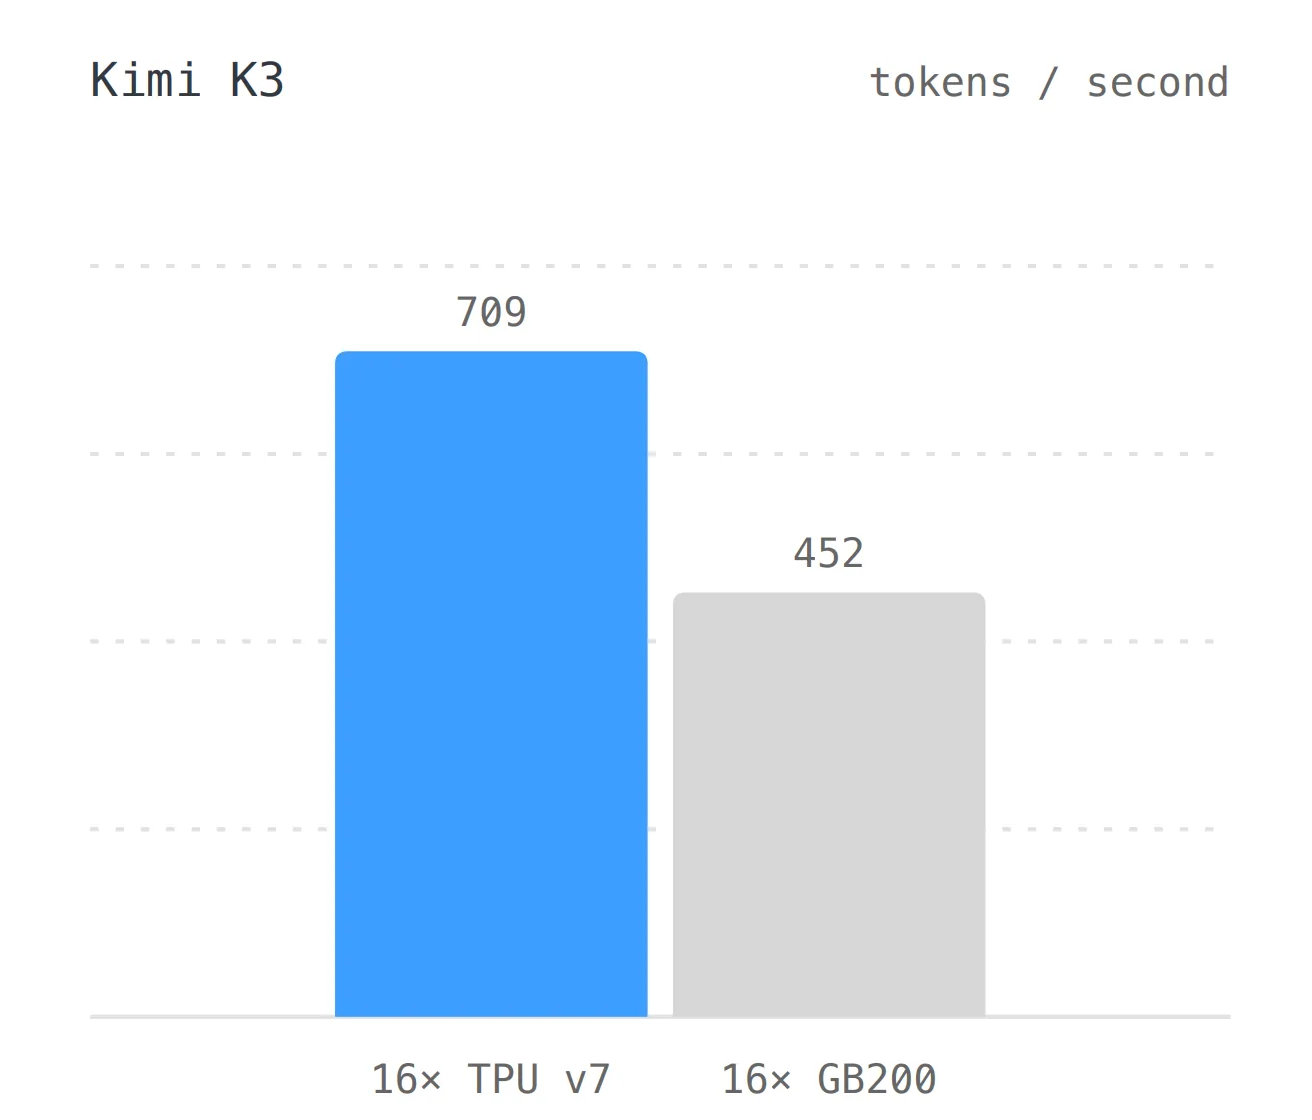
- 2026年9月23日:海外推理优化团队Inferact开源tpu-megakernels项目,用16颗Google TPU v7芯片将整个K3模型装入单一kernel
- 原始K3模型官方推荐需64卡以上服务器才能部署,未经优化初始性能约10 tokens/s
- 浪潮方案实测Token生成时延降至5.85ms,单用户吞吐170 tokens/s;Inferact方案低并发解码吞吐达709 tokens/s
算子融合:打破Kernel边界,直击内存瓶颈
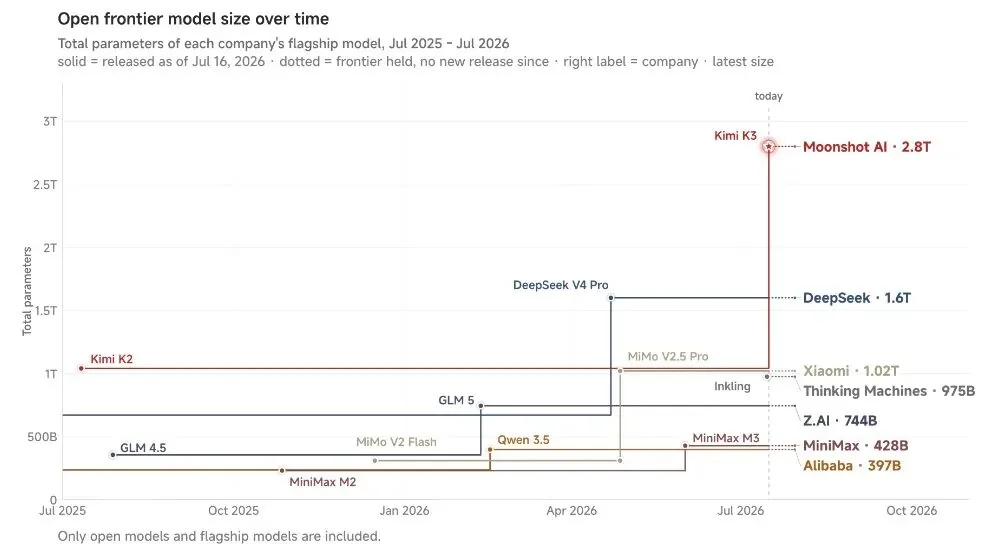
Kimi K3达2.8万亿总参数、104B激活参数,每轮前向计算需约1.5TB HBM带宽,且触发超120次All-to-All通信。传统推理框架因大量碎片化Kernel启动,产生显著"空泡"延迟。
双方技术路径的意外反差在于:
- 海外Inferact选择极端融合路径——整个Decode过程压缩进单一megakernel,利用TPU v7的64 MiB片上VMEM显式管理数据生命周期,实现计算与数据预取重叠
- 浪潮采取工程务实路径——将众多基础算子融合为超级算子,算子数量降低10倍,配合通信-计算协同流水线,推理性能提升3倍以上
两种路径本质指向同一结论:传统"一Op一Kernel"的松散模式已成效率天花板,系统层融合成为破局关键。
超节点系统战:128芯紧耦合的三大突破
浪潮SD200 Ultra构建系统级优势,核心突破包括:
- 3D Hyper Mesh互联架构:紧耦合128芯本土AI芯片,通信时延低至0.69微秒
- 统一编址显存:提供8TB统一编址显存与64TB内存,通过对称内存技术,首次在本土芯片超节点实现GPU显存直连,AllReduce通信时间降低3.5倍
- 超级算子智能体:引入Kimi K3自身参与优化流程,由AI智能体生成Tile级流水超级算子,性能较人工优化方案再提升50%,形成"用K3优化K3"的循环加速
推理优化范式转变:AI成为优化基础设施的工具
浪潮引入"超级算子智能体",将模型从被优化对象转为优化工具本身。其工作方式类似高铁 vs 绿皮火车的比喻:
- 传统方式:数百个算子串联执行,反复启停、写回中间结果至HBM
- 超级算子:前步结果直接驻留寄存器/片上缓存供后步使用,通过异步搬运与多缓冲实现预取-计算-写回三阶段流水并行
该范式显著降低人工优化成本,为系统级效率迭代提供可持续路径。
落地建议
- 适合采用DSPark+Megakernel方案者:具备TPU v7硬件环境、追求极致低延迟解码的前沿研究团队,开源tpu-megakernels提供快速验证路径
- 适合选用SD200 Ultra超节点者:需要稳定部署2.8T参数模型的国产化替代场景,尤其看重统一显存编址与系统级吞吐保障的商业部署
- 建议再等等者:期待单芯片极致性能者应关注本土芯片底层算力进展,当前超节点方案的瓶颈仍在芯片单卡上限
写在最后
当算力竞争从芯片规格走向系统组织力,中国团队通过超节点与超级算子的组合创新,开辟了在芯片工艺受限条件下的确定性追赶路径。Megakernel与超级算子两条技术路线的 converge,标志着大模型推理效率革命正式从模型层深入至系统层深水区。