
抖音上刷到一条短剧合集《首尔今天有点鲁》,标签带着 LibTV。第一观感和大部分AI短剧不一样:人物的眼睛有焦点,会跟着对话对象走;表情有起承,笑容是慢慢展开的而不是瞬间挂上去的;吵嘴戏里两个人的神态张力是真实的。看起来"特别自然、传神"。
这就引出一个问题:这种自然,到底是提示词写得足够细的结果,还是别的原因?
为了回答它,我把这部短剧的同款制作教程完整扒了一遍——YouTube 上有一套 3 小时 12 分钟的全流程实操课,标题直接写着"即梦 Seedance2.5 + LibTV 制作 AI 真人短剧",章节从剧本一直排到二次剪辑。我把整套视频下载下来抽帧分析,结论先说:提示词只是最后一层。真正让眼睛和表情自然的,是三层结构:角色资产先行、多图参考约束、模型本身的演技。 提示词写得细当然有用,但它是在前两层铺好的地基上才发挥作用的。
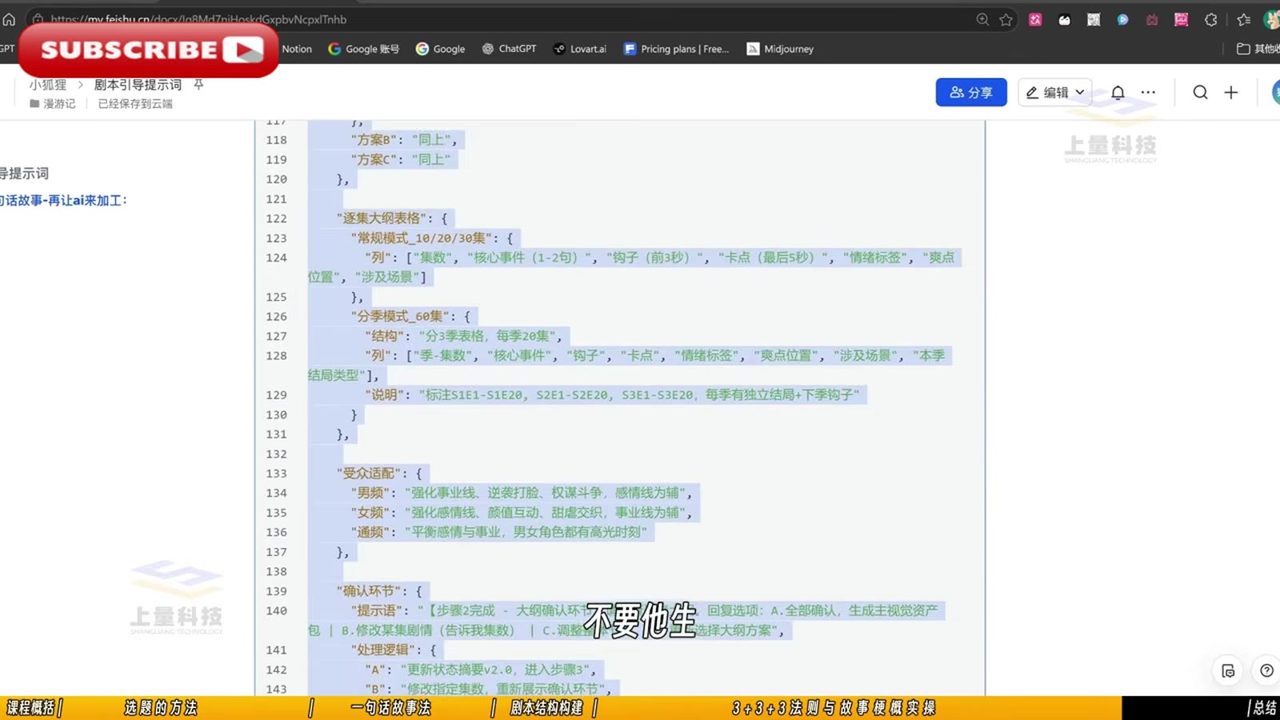
先看证据链
教程开头放的成片示例,和《首尔今天有点鲁》是同一套质感:
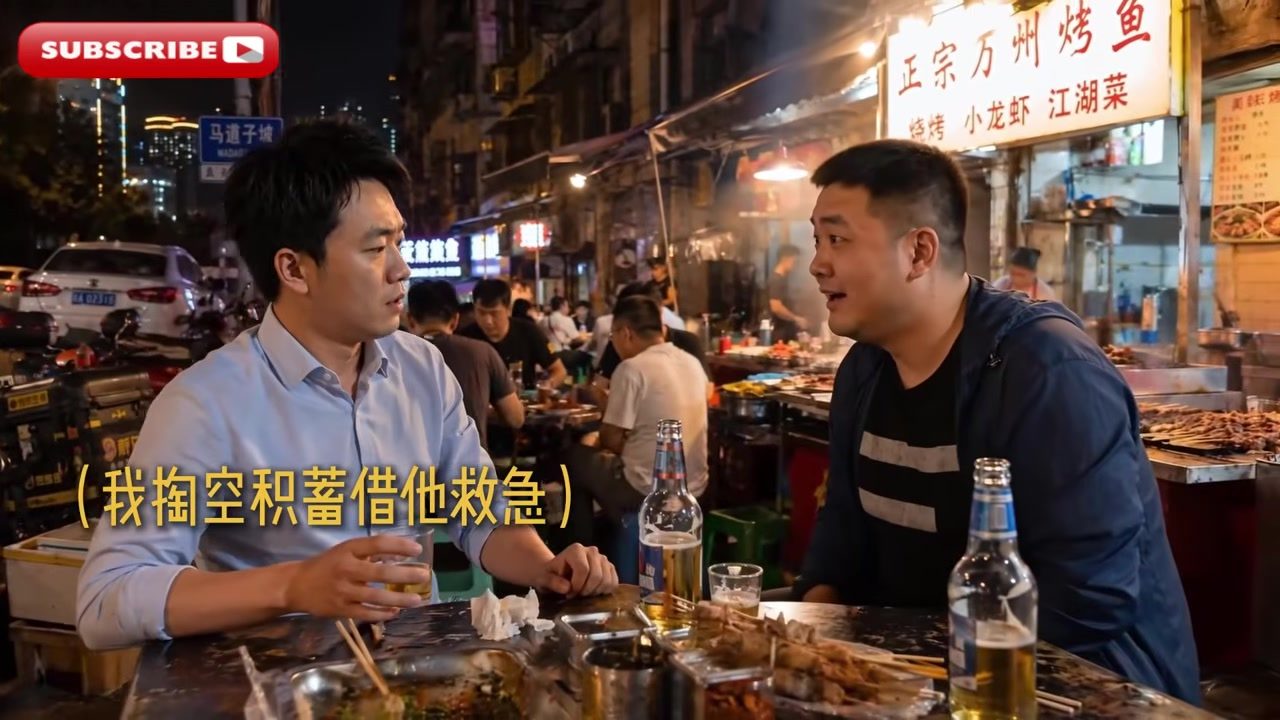
夜市摊位,两个男性角色饭桌对坐。用视觉模型逐帧审这批示例镜头,评价相当一致:人物皮肤质感、环境烟火气、两人眼神方向的对位都接近实拍;瑕疵也存在——背景人物细节发糊、张嘴说话的瞬间口腔区域有生成痕迹。“自然"背后是工程取舍:容易穿帮的部分(手部特写、长对话正反打)用镜头语言规避,优势部分(静态神态、光影、皮肤纹理)尽量放大。
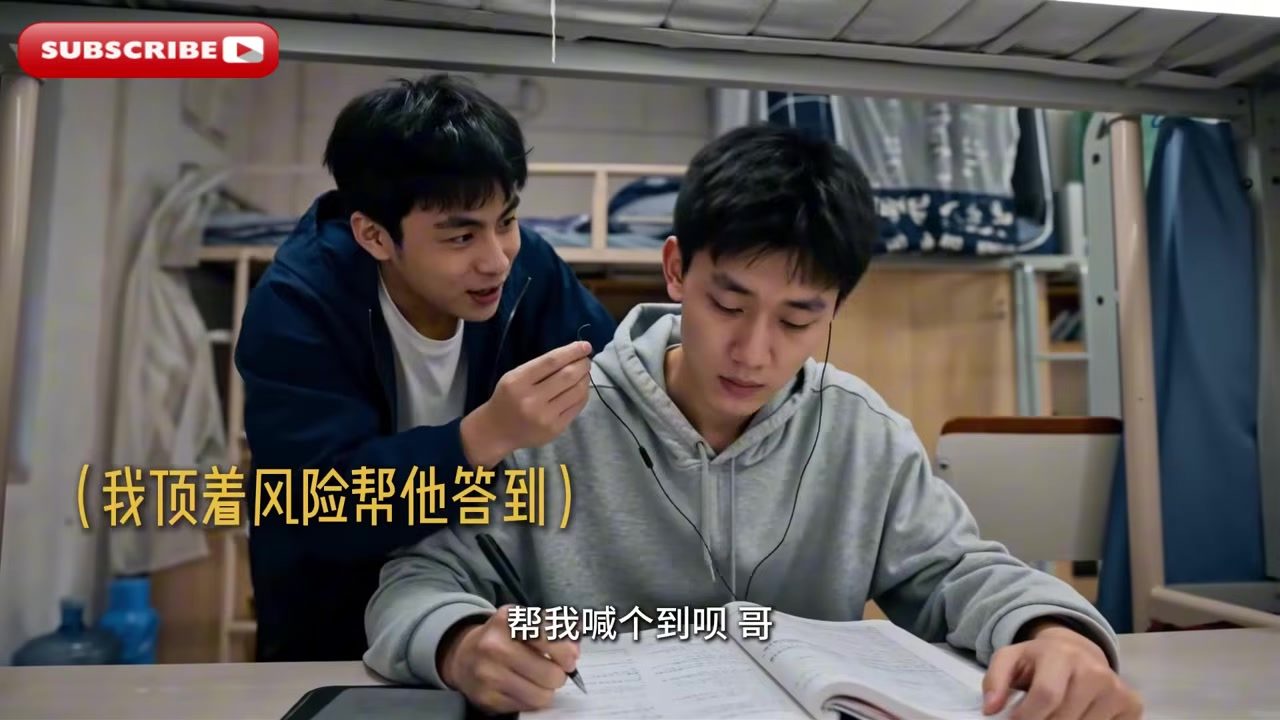
宿舍场景里"帮我喊个到"的镜头,人物神态带狡黠感,低头写字的一方表情被动——这些情绪状态在单帧里就能读出来。整套示例给我的整体判断:它是用多参考图生成的短镜头拼接,每个镜头 5-15 秒,靠剪辑节奏掩盖单镜头的物理不连贯。
第一层:角色资产先行,不是先写提示词
教程的章节顺序暴露了真实的制作顺序:
- 前言与工具介绍(即梦基本功能、Seedance2.5 四大优势、LibTV 基本功能)
- 从故事到剧本
- 提示词结构(RTCF 框架)
- 资产:人物、场景、道具设计
- 分镜与运镜
- 文戏与武戏
- 逐幕视频生成与剪辑
- 二次剪辑
注意第 4 步。大部分人对 AI 视频的理解是"写一段描述→生成视频”,但这条产线是反过来的:先给每个角色建立完整的角色资产库,再让所有镜头从库里取材。
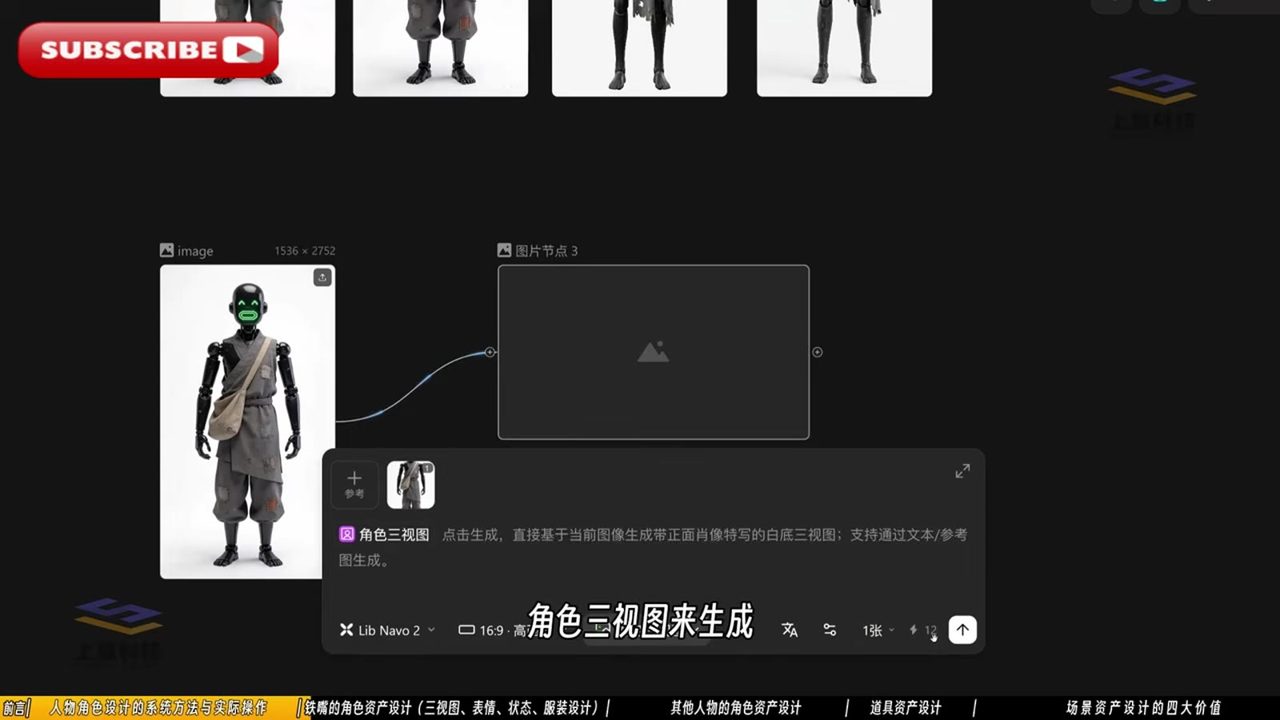
教程里演示的角色叫"铁嘴",一个穿破旧布衣的机器人。它的资产包含:
- 三视图:LibTV 有专门的"角色三视图"节点,基于一张角色图直接生成带正面肖像特写的白底三视图
- 表情库:画面里能数出 Happy、Curious、Wink 等表情卡片,每个表情单独存为资产
- 状态与服装:LED 眼色变化(悲伤、猩红警报)、不同场景的着装版本
真人角色同样走这套。清朝太监角色的生成提示词抄录如下:
| |
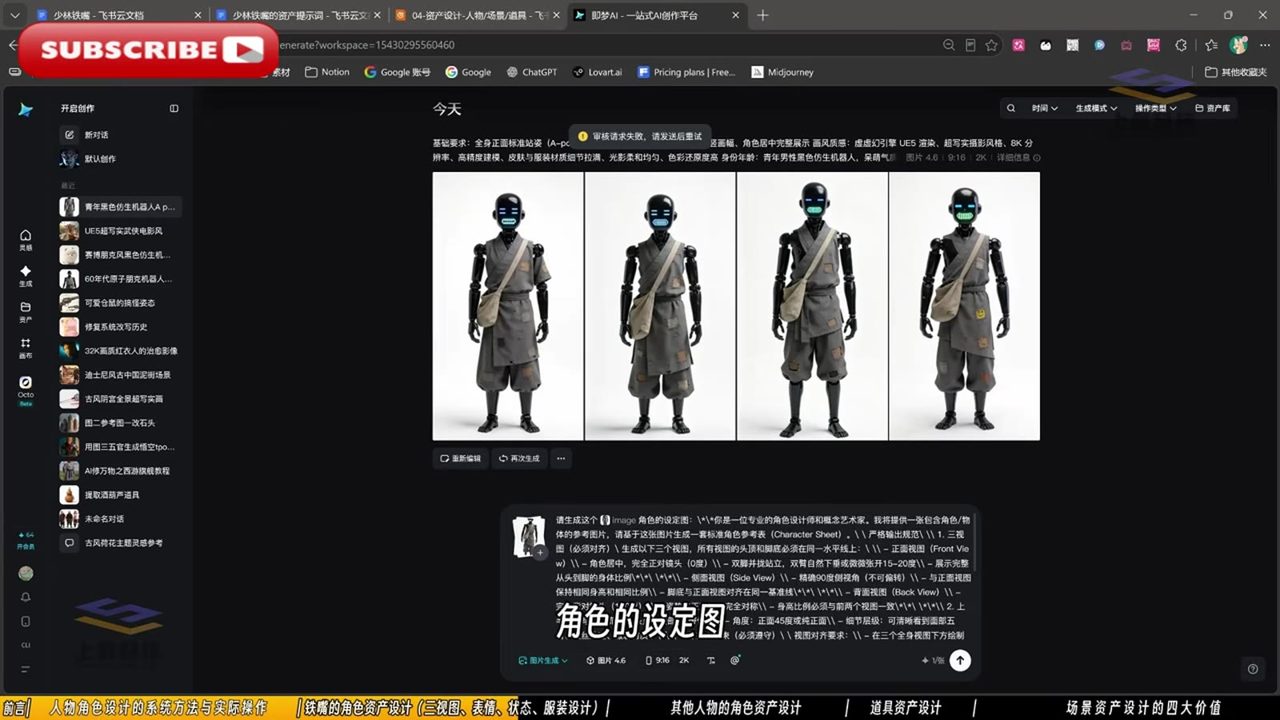
这段提示词值得细看。它描述的并非某个具体镜头,而在定义资产规格:站姿标准(A-pose)、背景纯净(白底)、光照均匀(中午室内自然光)——全部是为了后续步骤好取用。身份用一句"40岁太监,驼背"锚定,形体特征直接写进人设。
这就是眼睛自然的第一重原因:所有镜头里的同一张脸,来自同一组资产图。 角色一致性靠生成时把角色资产图作为参考图直接喂给模型维持,脸是"贴"进去的,每次生成无需重新想象。
第二层:多图参考,把调度权从模型手里拿回来
教程后半段进入 LibTV 画布实操,这里是我认为整条产线技术含量最高的部分。
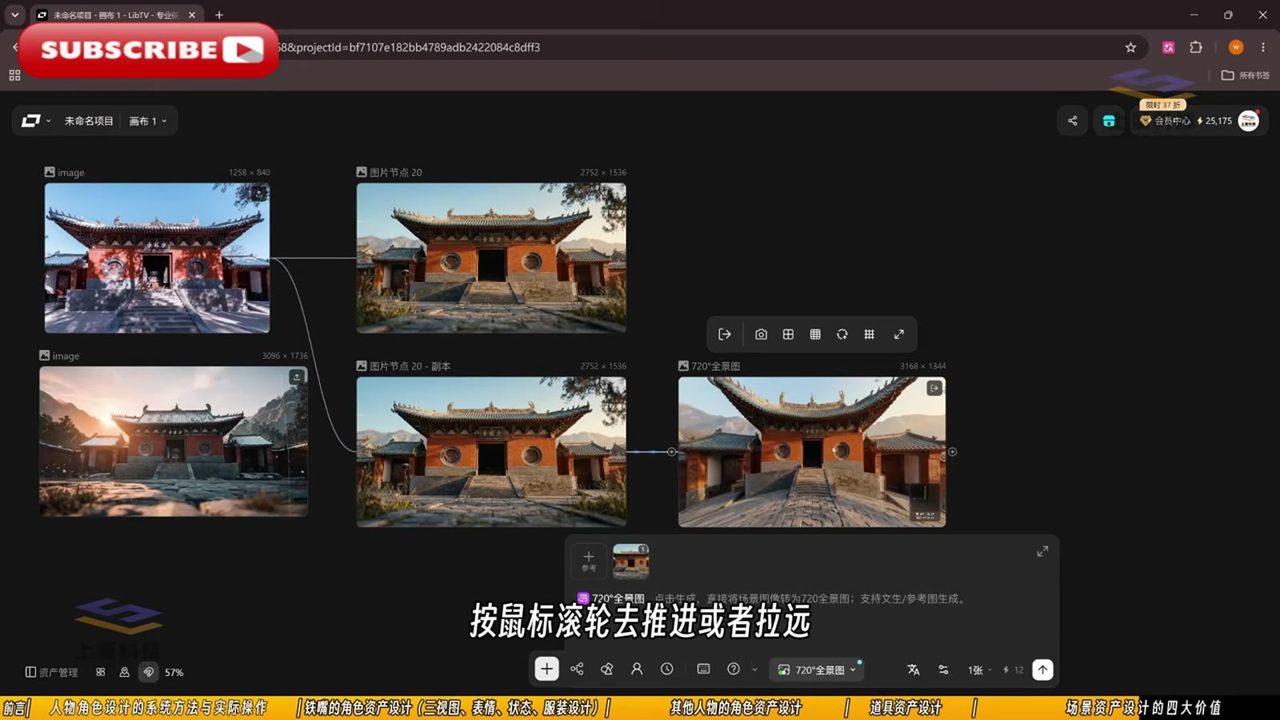
LibTV 是节点式工作流:图片节点、文本节点、视频节点在画布上连线,素材从左往右流。视频生成面板有五种模式:文生视频、全能参考、图生视频、首尾帧、图片参考。
实际生成镜头时,提示词长这样:
| |
数一下:一个镜头挂了 8 张参考图。角色归角色(图片1-5、8),场景归场景(图片6-7),提示词正文里用【图片N】做指针,指名道姓地调度每个资产。
这对应 Seedance2.5 的"全能引用模式"——单次生成最多可混合引用 9 张图片、3 段视频、3 段音频。36氪的报道里提到,这个能力让从业者抽卡效率提高了"至少十倍"。
眼睛自然的第二重原因在这里:表演的对象是确定的。 当【图片4 方丈】和【图片8 惠能】在同一镜头里对视时,模型不需要凭空生成两个陌生人的互动,它是在两张既定人脸之间生成眼神交流。瞳孔位置、视线落点、微表情的肌肉走向,都有参考可依。这是纯文生视频永远做不到的。
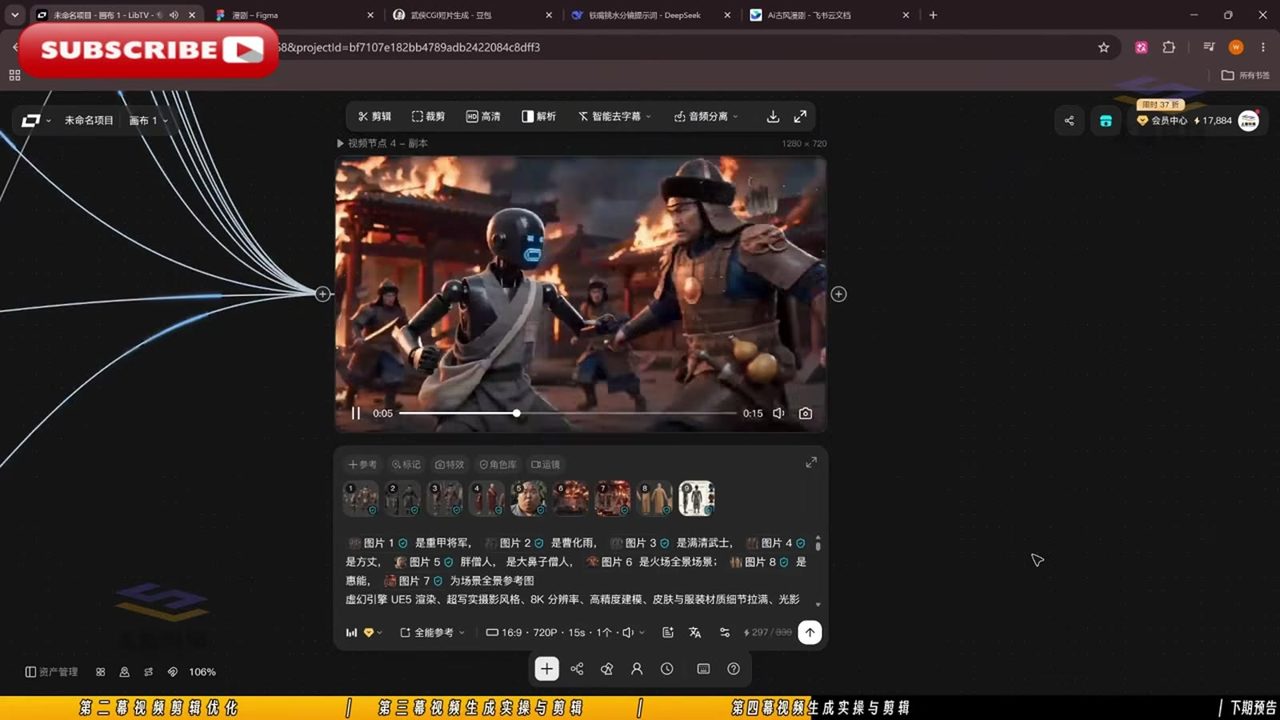
文戏的提示词结构更能说明问题。教程里给出的镜头提示词模板包含:风格核心、视觉基调、场景、背景人物、中景人物站位、人物比例关系、前景遮挡、限定词。站位和比例关系单独成项——这意味着创作者在提示词层面控制"谁离镜头近、谁的脸占多大、谁被谁半遮"。神态特写之所以传神,是因为创作者一开始就规划了这个镜头的脸部占比。
第三层:模型本身的演技
前两层解决"脸对不对",第三层解决"演得像不像"。
2025-2026 这代视频模型的共同进步是把"声画同出"做实了:口型、音效、情绪节奏在生成时同步输出。即梦 Seedance2.5 在人物真实感上的口碑有实测支撑——第三方对比测评里,即梦生成的人物"皮肤和头发带有一些自然的瑕疵,反而更像真人"。
但模型短板也明确存在。36氪报道引述从业者评价:即梦"面部表情不够细腻,比如微笑表达过于急促或有缺失,还得靠演员来演"。这条产线对此的应对方式藏在剪辑章节里:
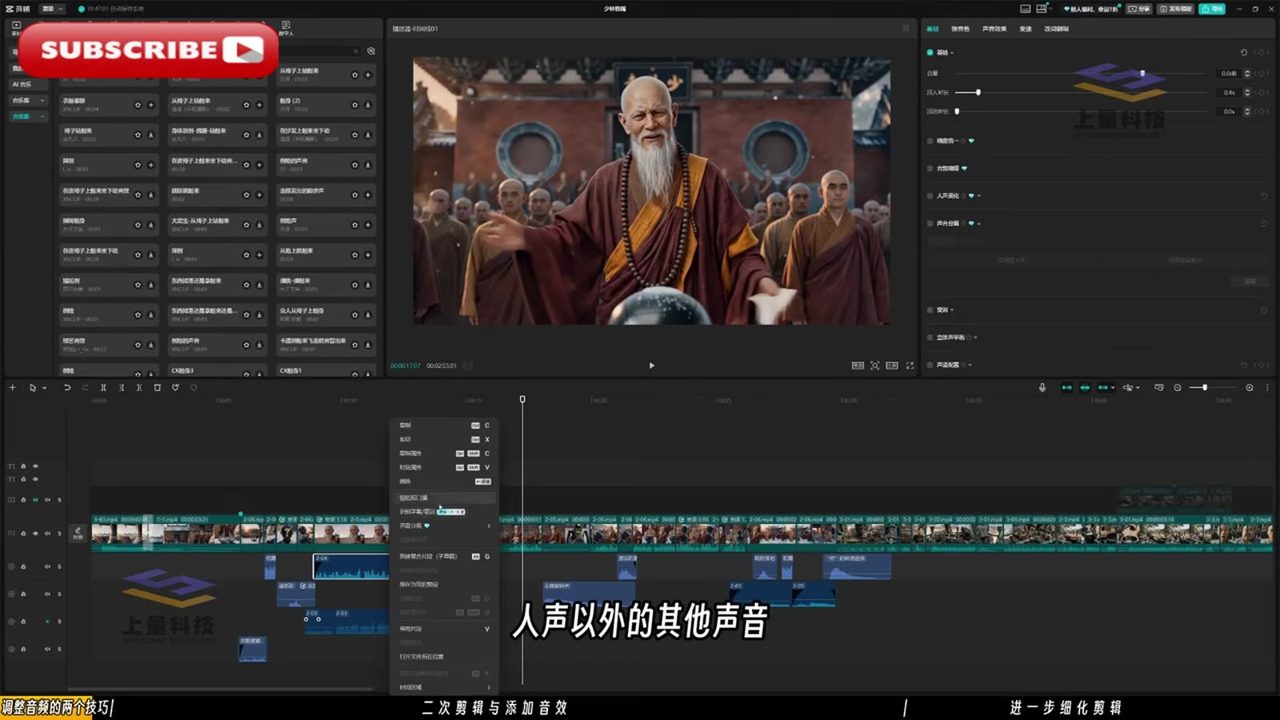
教程最后两章是剪映二次剪辑与添加音效。左侧素材库能看到大量音效点位,音频淡入淡出逐段手调,还有"智能去字幕"之类的清理工具。AI 镜头之间用剪辑节奏衔接,音效、配乐、节奏点全部在后期手工补。 微笑太急的镜头剪掉重抽,情绪铺不满的位置用音乐垫。
所以第三重原因:模型演技不够的部分,靠抽卡加剪辑兜底。你看不到穿帮,是穿帮的镜头没被留下来。
回到最初的问题
提示词写得细不细?确实细。光线一门课就拆成光源(自然/人造)、光质(硬光/柔光)、光向(侧光/逆光/顶光)、光影(明暗面与阴影)、光色(冷/暖/青橙对抗)五个维度逐项教学。RTCF 框架把风格、构图、视距、视角、视高、光线、色调的排序顺序都规范化了。
但把《首尔今天有点鲁》的"自然"归功于提示词细节,就像把一道菜好吃归功于摆盘。真实的结构是:
- 资产层:角色三视图+表情库+状态库,脸和神态有标准件
- 参考层:单镜头最多 9 图引用,角色场景分轨挂载,视线互动有据可依
- 生成层:模型对口型、情绪节奏的原生支持,加上微笑急促就重抽的人工筛选
- 后期层:剪辑节奏、音效、配乐把 5-15 秒片段缝成连续叙事
提示词是这套系统的人机接口,不是系统的发动机。
顺带一提教程里的剧本方法论,倒是出乎意料地"传统":3+3+3 法则(3个钩子设计+3次情绪起伏+3个反差冲突点),分集大纲表格包含钩子(前3秒)和卡点(最后5秒)两列——和真人短剧的爆款公式完全同构。AI 换掉了摄影机和演员,没换掉叙事规律。
成本侧的变化更剧烈。传统真人短剧单集 5-10 万元,这条产线单集压到 5000 元以内。字节漫剧的日 token 消耗 2026 年已突破 7000 万元,超过真人短剧。眼睛自然的 AI 演员背后,是一门被重构了成本结构的生意。
如果自己上手做:工具清单与真实成本
教程跑通了流程,但照抄它的工具组合未必划算。下面是我实际核算后的账本,价格全部来自 2026 年 9 月各平台官方页面。
先搞清楚 LibTV 是什么、多少钱
LibTV 是 LiblibAI(哩布哩布)推出的节点式 AI 视频工作流平台,核心卖点是"画布+节点":把多模型(Seedance 2.5、Wan 3.0、Minimax H3 Max、Kling 3.0、Happy Horse 1.1)和资产库、剧本、智能分镜、剪辑整合在一个画布里,不用在五个网站之间切换导素材。教程里那些"角色三视图一键生成"“720°全景图"“多主体参考"都是它的节点功能。
它的订阅价格(2026 年 9 月双节活动价,创作会员档):
| 档位 | 价格 | 折合月费 | 积分/月 | 1积分价值 | 备注 |
|---|---|---|---|---|---|
| 标准版 | ¥729/年(次年¥599) | ¥47 | 1500 | 0.032元 | 8并发、60GB存储 |
| 进阶版 | ¥2199/年(次年¥1799) | ¥100 | 4600 | 0.022元 | 12并发、100GB |
| 高级版 | 约¥4999/年档 | ~¥190 | 11700 | ~0.019元 | 20并发、300GB |
| 豪华版 | ¥14999/年(次年¥7399) | ¥583 | 32800 | 0.018元 | 无限并发、600GB |
| 至尊版 | ¥22999/年(次年¥10999) | ¥858 | 50500 | 0.017元 | 无限并发、1000GB |
关键要看懂这张表:积分单价随档位升高而降低,但绝对支出单调递增。 标准版每月 1500 积分,按 Seedance 2.5 720P 的积分消耗(官方表格:标准版每月约生成 33 秒该模型视频)折算,约等于每月 45 积分/秒,这是重度视频生成的档位门槛。
免费层也真实存在:登录每日赠 20 积分、每日 2 次 5 折视频、3GB 云存储、新人注册送 100 积分。但 20 积分连一条 5 秒 720P 视频都生成不了(按上表比例约需 225 积分),免费只够摸界面。
替代方案:按你的目的选
目的一:只想复现《首尔今天有点鲁》这种短剧,不订阅 LibTV 也行。
LibTV 的价值在"工作流整合”,底层模型全部可以从原厂直接用:
- 即梦(jimeng.jianying.com):字节官方,Seedance 2.5 的原生入口。会员 ¥69/月起、¥659/年,免费用户每日 60-100 积分。注意 4 月那轮涨价:基础/标准/高级年费 659/1899/5199 元,首年折扣从 5 折调到 6 折,月积分从 1080/4000/15000 缩水到 725/2210/6160,从业者测算"一条 15 秒视频成本相差数倍”。但个人轻度使用,¥69/月仍是官方渠道最低价。
- 可灵(klingai.com):快手官方。API 计价清晰:Kling 3.0 720P 无声 0.6 元/秒、有声 0.9 元/秒,1080P 0.8-1.2 元/秒;图片 Kling Image 3.0 一张 0.2 元。创作台订阅另算。它的镜头叙事感和电影级画质在《纸手机》《太平年》这类作品里已被验证,但角色一致性靠"主体库"而非多图引用,工作流自由度低于 LibTV。
- Wan 2.5/3.0(阿里通义):阿里的 Happy Horse 1.0/1.1 走 API 路线,LibTV 上限时 4 折。质量上对打戏和物理模拟更稳,但中文提示词的"分镜思维"不如 Seedance。
目的二:想要即梦的模型但绕开订阅坑,走 API。
火山引擎官方 API(按 token 计费,仅对成功生成的视频收费):
| 模型 | 720P 5秒 无参考 | 折合单价 |
|---|---|---|
| doubao-seedance-2.5 | ¥7.56/条 | ¥1.51/秒 |
| doubao-seedance-2.0 | — | 约¥0.9/秒 |
| seedance-2.0-mini(企业限时4折) | — | ¥0.2/秒起 |
第三方渠道(如 Atlas Cloud)Seedance 2.0 快速版低至 $0.022/秒(约¥0.16/秒),但从业者反馈"API 接口不稳定,生成质量有波动"。个人短剧创作优先官方渠道,第三方适合批量跑量。
我的推荐配置(个人创作者,月预算 ¥100-300)
- 剧本与分镜:豆包/DeepSeek 免费,写 3+3+3 结构的分集大纲+分镜表(教程同款方法,飞书文档管理)
- 角色资产:即梦 ¥69/月会员,生成三视图+表情库(教程里那套"A-pose 白底+UE5渲染"提示词直接抄)
- 视频生成:短剧模式优先即梦 Seedance 2.5(全能引用,9图参考);预算紧时 Seedance 2.0 mini(API ¥0.2/秒,720P 15秒镜头约 ¥3)
- 剪辑:剪映免费版(教程同款),音效用它的素材库
- LibTV 订阅:月产 5 条以上再考虑进阶版(¥100/月);低于这个量,即梦+剪映的组合省下 ¥2000+/年
一个 20 集×1 分钟的竖屏短剧,按 Seedance 2.5 API 720P 全程生成(约 20 分钟素材量),纯算力成本约 ¥1800(按 ¥1.51/秒);换成 mini 模型+抽卡重试率 3 倍,约 ¥700。这就是"单集 5000 元以内"的构成:算力 ¥35-90/集,剩下是人的时间。
附:教程出处与考证方式
同款教程为 YouTube 频道的《即梦 Seedance2.5 + LibTV 制作 AI 真人短剧》全流程实操课,发布于 2026 年 8 月初,总时长 3 小时 12 分钟,含 10 个章节。本文全部界面截图与提示词抄录,来自对该视频的逐帧分析(1/10 秒抽帧 + 高清关键帧放大识别),工具与流程描述以视频实操画面为准。模型能力数据参考 36 氪《即梦和可灵,能不能接住AI短剧风口?》、东方财富/蓝鲸财经即梦涨价报道、火山引擎官方定价页与 LibTV 官网订阅页。
注:文中"铁嘴"“武痴七号"等角色名与提示词片段均为教学演示内容,非《首尔今天有点鲁》正片素材;成片示例截图用于风格判断,观看原片请移步抖音。