
核心事件:骁龙平台首现开源微型LLM
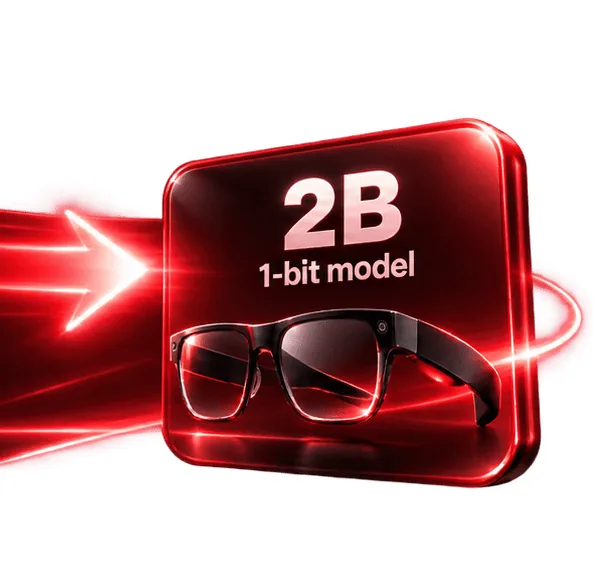
2026年9月23日(周三),在高通骁龙技术峰会上,AI初创公司PrismML正式发布了其专为智能眼镜定制的微型语言模型版本,首次实现基于骁龙AR1 Gen 1平台的本地大模型推理。硬信息要点如下:
- 发布时间:2026年9月23日(高通峰会现场演示)
- 新版本:Bonsai LLM,20亿参数,1-bit量化,专为视觉-语言任务优化
- 运行平台:Qualcomm Snapdragon AR1 Gen 1 AI智能眼镜
- 是否开放权重:是,PrismML主张开源权重(open-weight)架构
- 何时可用:尚无具体上市的智能眼镜产品 announced(尚无搭载该模型的终端设备公布)
技术细节与行业突破
PrismML由加州理工学院研究人员创立,学术背景强大,导师为加州大学伯克利分校的Ion Stoica教授。其核心技术在于“极度压缩但不损失性能”的模型压缩策略。
本次展示的Bonsai LLM是典型的4倍压缩版大模型——在保持近乎原始性能的前提下,将模型体积减至原来的四分之一。这在AI硬件资源受限的智能眼镜场景中意义重大。
模型参数规模为20亿(2B),专为多模态任务设计,使用户能就所见事物进行实时语音问答。例如佩戴者看向一件陌生物品,设备可本地生成其名称与功能描述,无需依赖云端。
一项关键反差数据值得注意:20亿参数在大模型动辄百亿千亿参数的时代看似“微小”,但其压缩前的基准模型通常需10亿以上参数便已难以在边缘设备运行;PrismML通过1-bit量化将计算需求降至极低,却仍能在标准 benchmarks 上保持近乎原始性能——这意味着高通芯片的算力除传统任务外,首次具备了承载实用级NLP/视觉推理能力的潜力。
高通选择在骁龙峰会直接演示该模型,说明其已进入可验证阶段。Snapdragon AR1 Gen 1平台本身定位为增强现实专用SoC,支持 Emmy 8K视频处理与AI加速器;PrismML的加入使其从“视频处理设备”向“认知增强设备”迈出关键一步。
模型压缩方式简表
| 特性 | 基准模型 | PrismML Bonsai |
|---|---|---|
| 参数量 | 未披露 | 20亿(2B) |
| 量化级别 | 未披露 | 1-bit |
| 压缩比 | 1× | 4× |
| 性能保留 | — | 几乎全部 |
| 运行方式 | 需云端/高性能GPU | 本地骁龙设备 |
落地建议:谁适合关注与尝试?
企业AR开发团队:若Plan在智能眼镜端部署问答/辅助识别功能,PrismML提供了无需云端依赖的可行路径;建议关注其后续模型发布与API支持。
开发者社区:其open-weight模型开放策略,意味着研究者可自由复现与改进,比封闭商业模型更具实验自由度;推荐在骁龙开发套件上先行测试。
一般消费者:建议再等等——目前无任何搭载PrismML的消费级智能眼镜上市;即使有原型机,隐私计算、续航优化与问答延迟仍是量产前需跨过的真实门槛。
写在最后
PrismML的策略直指当前AI产业两大隐忧:数据隐私与算力过度中心化。当企业与研究者意识到,无需将每一次交互交给云服务器,本地推理挑战将被技术进步逐步击穿;而高通与PrismML的合作,则表明芯片厂商正从“算力供应商”转向“AI生态共建者”。这或许预示着,边缘AI的下一波浪潮,将不在芯片参数,而在模型适配。