
核心事件:英伟达开源SoL-Pi,实现AI自优化工作流
2026年9月,英伟达正式开源SoL-Pi(Speed-up and Optimization of Learning - Pi),一套专为AI Agent工作流设计的高效 Harness(框架)。该系统不依赖模型能力升级,而是通过优化工作流程结构实现降本增效。核心硬信息如下:
- 发布时间:2026年9月(新闻发布时间)
- 开放状态:完全开源,项目地址:https://nvlabs.github.io/SoL-Pi/
- 技术基础:基于开源项目 Pi 改造
- 核心能力:AI 自动筛选并部署优化机制,无人工干预
工作原理:152个方案筛选出4个黄金机制
SoL-Pi 的关键突破在于其独特的"自动研究循环"(Automatic Research Loop)。传统 RSI(AI Self-Improvement)方案依赖在线试错,90% 以上尝试最终失败,成本高昂。英伟达采用"共享快闪模式":系统维护一个最简工作模板,每个实验启动时复制模板自由修改,实验结束后临时代码直接丢弃,避免主库臃肿。
该流程共收集 AI 提出的 152 个优化想法,经自动化沙盒严苛淘汰,最终仅4个机制存活并构成核心骨架:
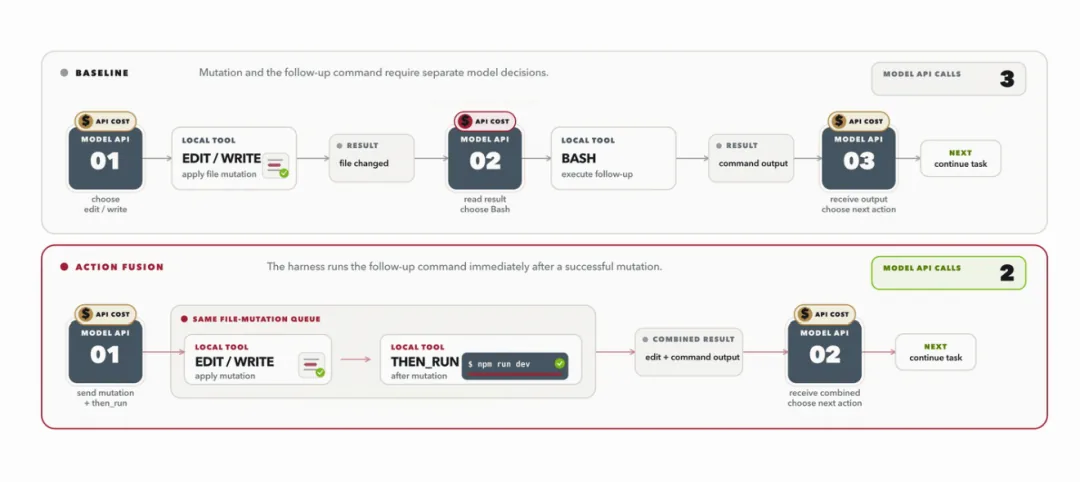
- 动作合并:将"改代码 + 跑测试"等固定连续动作合并为一步,减少一次 AI 推理开销
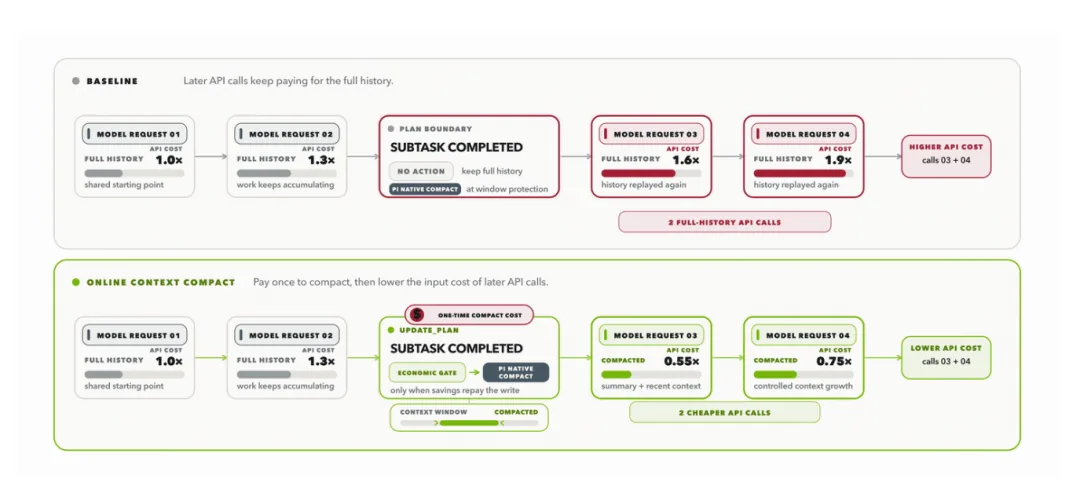
- 精简摘要压缩:大任务拆分为独立小任务,每完成一个即压缩历史为摘要,仅保留关键结论;上下文轻量化后,仅需摘要,必要时再调取原始记录
- 本地化结果存储:完整工具输出(如几百行日志)存本地,上下文仅保留"摘要 + 索引",按需调取
- 分层诊断报告:问题排查时,用低成本小模型将日志提炼为带原文锚点的诊断报告,主模型优先阅读摘要
这四个机制本质是针对 AI 工作流的"通病":记忆线性累加、工具输出冗余、分支决策碎片化。
效果验证:多模型同台竞赛,省钱效率实打实
英伟达搭建了 495+40=535个验证环境:
- 495个真实bug重现环境:从GitHub提取真实开源项目历史状态,隐藏人类修复方案
- 40个盲盒任务:无剧本沙盒环境,AI需自由探索触发验证器
测试对象对比四种 Harness:
| 对比方案 | vs Pi Token下降 | vs 原生框架最高下降 | API成本下降 | 每小时节省 |
|---|---|---|---|---|
| SoL-Pi | 45%–49% | 64% | 50%–54% | $8.75–13.5 |
| — | — | — | — | — |
反差数据:SoL-Pi 对比模型原生官方代理框架,Token 消耗最高骤降 64%(而非Pi),证明其优化效果超越基准模型自身框架。
落地建议:谁该立即尝试?
- 适合立即试用:已部署多Agent协作流程、单次任务Token消耗超10万的中大型团队;Git开发流程中频繁需要日志诊断与测试验证的工程团队
- 建议再等等:单一Agent任务、任务链极短(≤2步)的轻量场景;对模型调用延迟极度敏感(如实时交互)的业务,动作合并带来的推理跳跃可能需要适配
写在最后
SoL-Pi 的核心价值在于提出"Efficiency for efficiency"理念:效率既是结果,也是下一轮研究的资源。当AI优化自身工具而非仅追求模型变聪明时,节省的预算可反哺更多实验,形成正向循环。这种"广度优先"的探索——大量提出想法再自动化筛选——或许是当前降本增效最务实的路径。