
核心事件:Show-o 系列统一架构正式落地 ECCV 2026
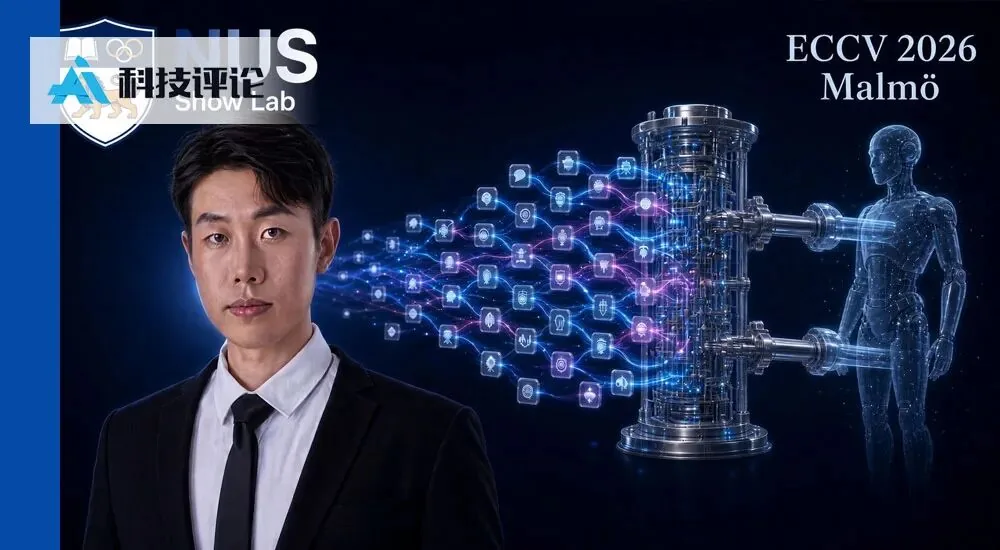
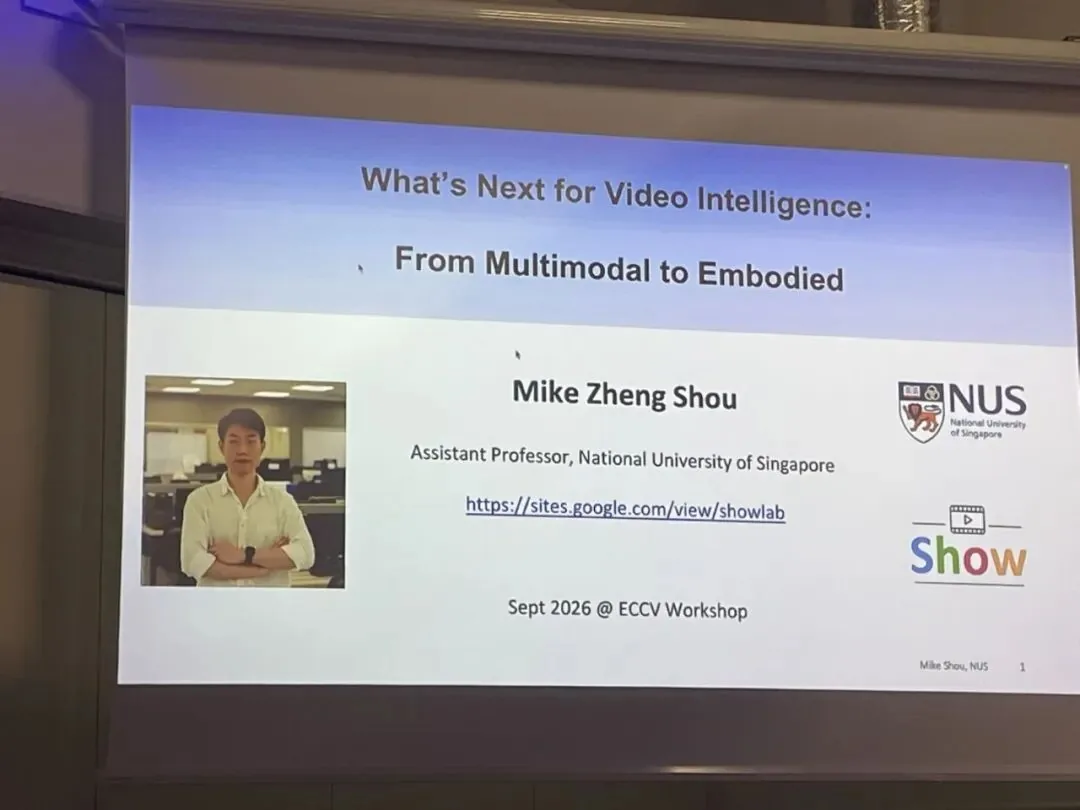
新加坡国立大学(NUS)Show Lab 在 ECCV 2026 上披露其 Show-o 系列统一多模态大模型的最新进展,标志着多模态架构从“实验玩具”向“具身大脑”的关键跨越。核心事实包括:
- 发布时间:ECCV 2026 现场正式披露(寿政教授主讲)
- 代表模型:Show-o 与 Show-2,后者实现从静态图像到连续视频生成的跨越
- 架构原创性:首个将自回归(AR)预测与离散掩码扩散(Discrete Diffusion)融合于单一 Transformer 的模型
- 技术开放性:源材料未提及权重是否开放;暂无具体发布日期或商用计划
- 关键赛道:多模态理解与生成 + 具身机器人决策
架构突破:打破“理解-生成”二元割裂
传统方案普遍采用模型拼贴路径——例如 NEXt-GPT 通过外挂扩散模块与大语言模型组合实现 Any-to-Any 交互,但本质仍是分立架构。Show-o 的反差在于:仅用一个 Transformer 就同步支撑理解与生成。
其底层设计包含三个关键重构:
- 架构缝合:将文本离散性与视觉连续性“死结”打通。AR 模式处理文本及图文交错数据;扩散模式(基于 Mask-and-Predict 机制)处理图像/视频生成,仅需十几步即可恢复完整视觉 Token
- tokenizer 升级:Show-2 引入 3D Tokenizer 实现图像与视频统一编解码;注意力机制采用“文本因果注意力 + 视觉时空双向注意力”混合策略,兼顾逻辑前向性与帧间连贯性
- 路径设计:实验发现完全共享编码器会导致理解精度微降,因此 Show-2 采用“共享输入 3D Encoder + 内部分立路径”;理解路径增加语义层蒸馏,保障理解精度同时维持生成画质
团队特别指出:传统自回归需逐 Token 预测数百个图像分块,效率低下;连续扩散虽快却难与 VLM 的离散 Token 无缝衔接——Show-o 通过离散扩散 + 统一 Transformer 在生成质量、推理效率与逻辑建模间取得平衡。
数据与训练:闭环自监督破解“标注荒”
具身智能长期受困于高质量标注数据稀缺,尤其在特定文化或低资源场景。Show Lab 提出循环一致性监督(Cycle Consistency)机制应对挑战:
- 观察:输入无标签图像
- 描述:利用理解模块生成描述文本
- 再合成:以该文本驱动生成模块重建图像
- 闭环优化:对比原始与重建图像差异构建自监督信号
该机制使模型能从 YouTube 无标签视频中自主提取物理常识,极大拓展了 Scaling Law 的数据边界。寿政教授强调:模型不仅用“理解”指导“生成”,更通过生成任务反向提升理解表征能力。
落地挑战:云端大模型与端侧微调模型协同
具身智能的成败关键在于毫秒级响应。团队部署策略如下:
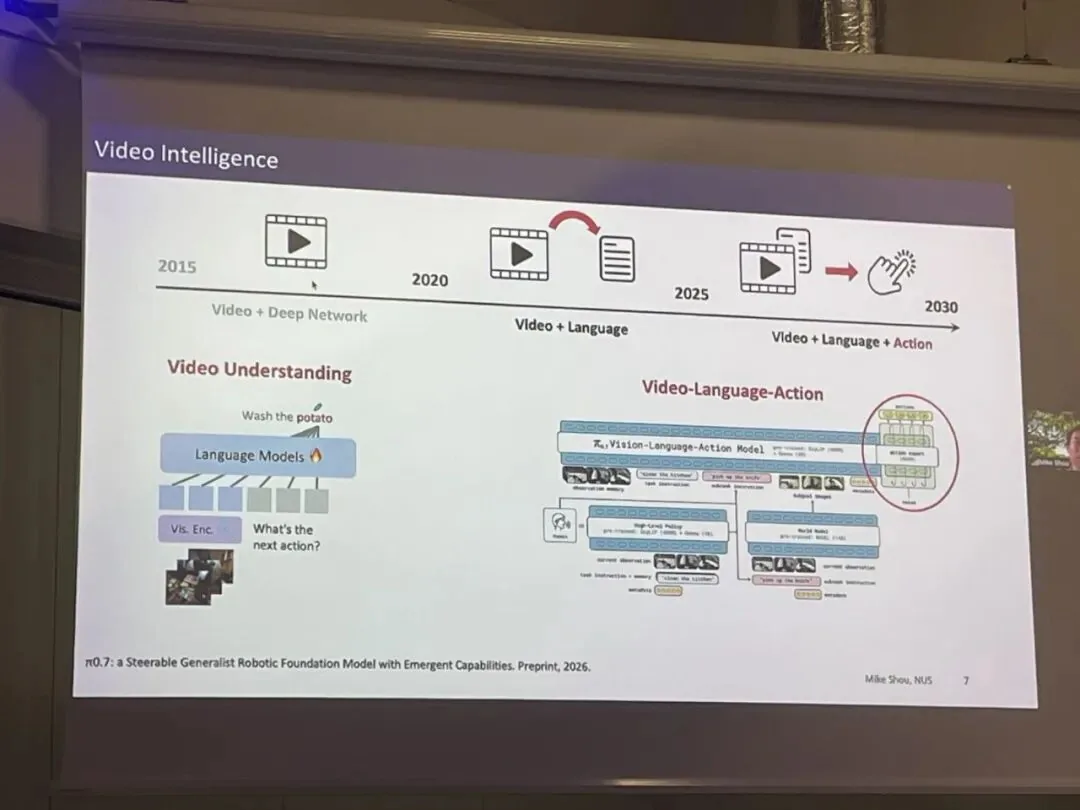
- 模型演进:从视觉-语言模型(VLM)→ 视觉-语言-动作模型(VLA)→ 世界模型(World Model)→ 世界动作模型(WAM)
- 部署组合:
- 云端:前沿大模型(规划能力强但单次决策需 8–20 秒)
- 端侧:开源底座微调模型(低延迟,响应更敏捷)
- 硬件平台:桌面双臂系统(夹爪/五指手)、轮式底盘+主动机械臂;通过双操纵手柄遥操采集“状态-动作轨迹”数据
读者建议与落地路径
- 适合谁用:多模态研究者、具身智能团队、需要统一模型简化推理链路的工程团队
- 建议再等等: 若依赖即用型 checkpoint 或商业 API,当前阶段尚不适用;若关注自监督数据效率或低延迟端侧策略,则值得深入拆解其循环一致性设计
写在最后
该工作揭示:统一架构并非技术完美的简单叠加,而是通过架构级重构释放“理解-生成”双向正反馈。当模型不再需要在“推理深度”与“响应速度”间二选一时,具身智能的“大脑”才真正具备了深思与本能协同工作的生理基础。