
核心事件
9月23日,小米MiMo大模型负责人罗福莉提前披露MiMo-V3的核心组件HySparse2,技术论文同步公开。这是距离9月22日MiMo-V2.6发布仅两天后的再次更新,显示小米大模型迭代节奏明显加快。
关键信息要点:
- 发布时间:2024年9月23日(预披露,非正式发布)
- 新架构名称:HySparse2
- 所属版本:MiMo-V3核心组件(尚未正式命名发布)
- 论文状态:已公开,15位作者,罗福莉为通讯作者
- 权重开放:未提及是否开源,仅论文公开
架构创新:两级KV共享如何降本增效
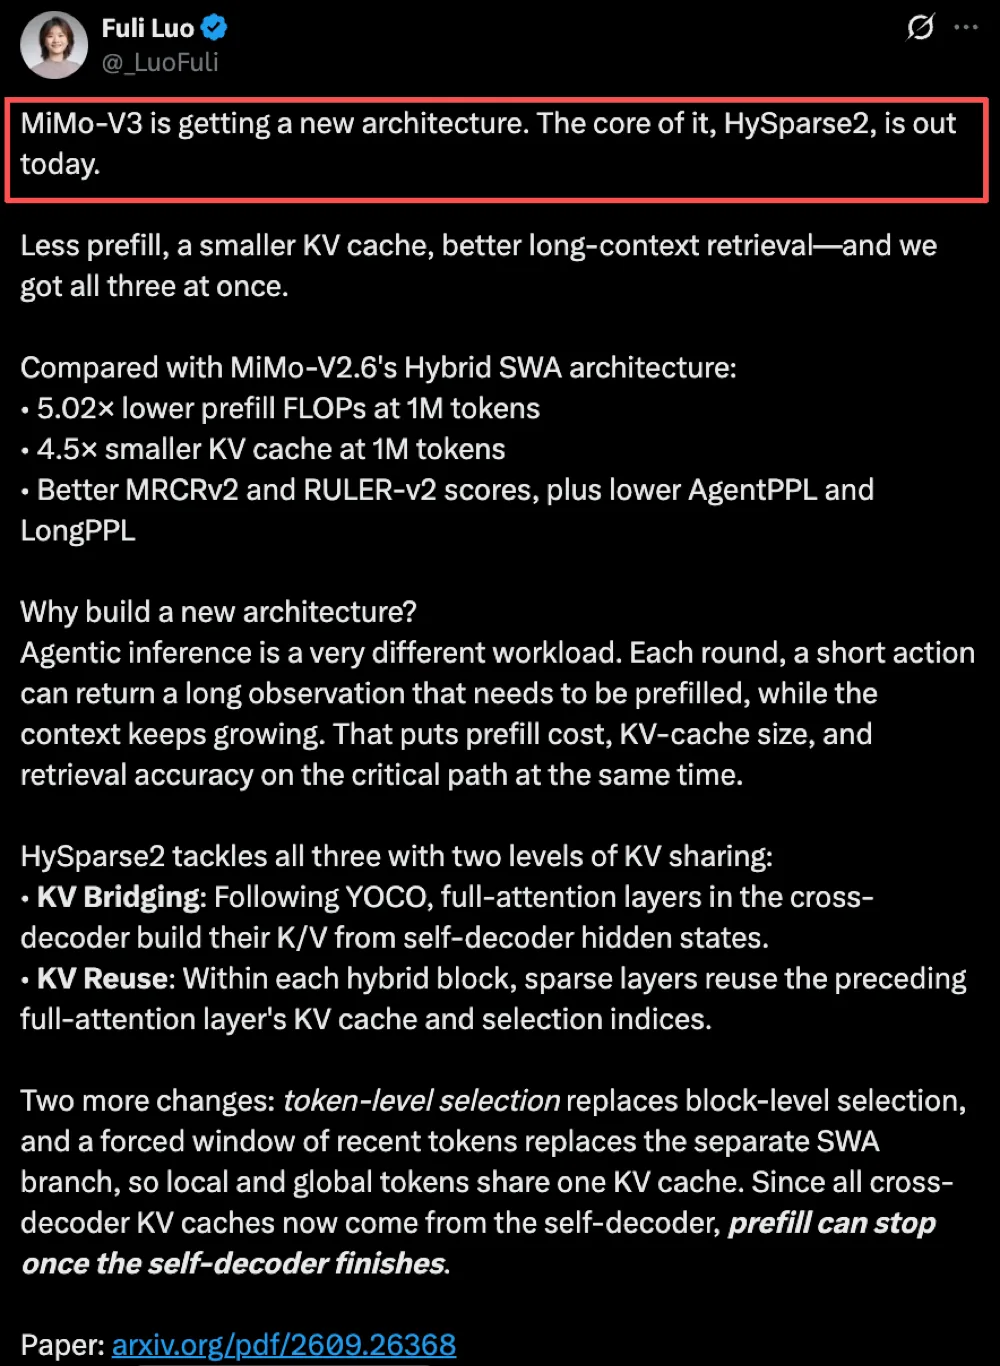
HySparse2主要针对Agent多轮任务中的三大瓶颈:长输入计算量过大、KV Cache缓存占用过高、长上下文检索不够精准。其设计核心是两级KV共享机制。
第一层:KV Bridging(KV桥接) HySparse2将模型主体拆分为Self-Decoder和Cross-Decoder两部分。Self-Decoder负责处理新增的长输入内容,其全注意力层生成的K和V可以直接被Cross-Decoder复用,避免后半部分重复处理已有Token。
第二层:KV Reuse(KV复用) Cross-Decoder中,一个全注意力层生成的KV Cache和Token选择索引,可被后续多个稀疏注意力层共享。这使得Prefill阶段只需执行前半部分网络即可完成缓存构建。
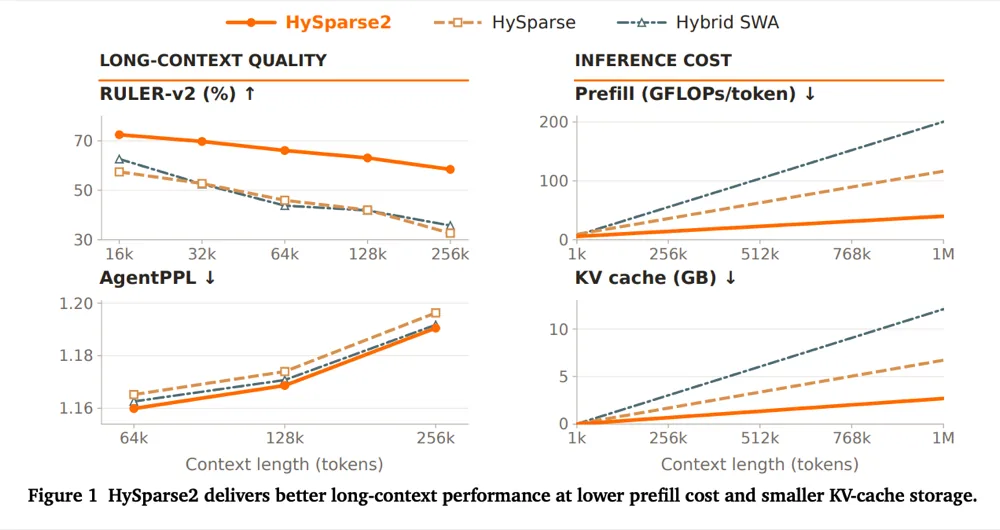
▲不同架构在长上下文下的Prefill计算量和KV Cache占用对比(Prefill FLOPs为相对Hybrid SWA基准的百分比)
| 架构 | 100万Token下Prefill计算量(相对值) | 100万Token下KV Cache占用 | AgentPPL | RULER-v2得分(256K上下文) |
|---|---|---|---|---|
| Hybrid SWA(MiMo-V2.6采用) | 100%(基准) | 12.09GB | 较高 | 35.74 |
| HySparse(上一代) | 34% | 6.72GB | 较高 | 32.61 |
| HySparse2(MiMo-V3) | 20% | 2.69GB | 最低 | 58.45 |
一个意外反差数据值得注意:在相同注意力预算下,HySparse2取消Cross-Decoder中的独立SWA分支后,虽部分数学推理成绩略有变化,但这种方法省去了额外投影参数和局部KV Cache,实现了架构简化与效率提升的平衡。
Token级选择与部署优化
相比HySparse的Block级稀疏选择(一次选取一整块连续Token),HySparse2采用Token级选择,可直接从上下文任意位置提取相关Token。这种设计更适合多轮Agent场景——例如当有用信息散落在早期工具返回的长文档中时,无需连带处理周围无关内容。
论文消融实验证明,Token级方案在RULER-v2、MRCR-v2和GraphWalks等测试上得分更高。
部署层面,以49层模型为例,Prefill与Decode分离时,Prefill节点仅需部署前25层(接近减半),且只需执行一个全注意力层,大幅降低硬件资源需求。
技术来源与参考成果
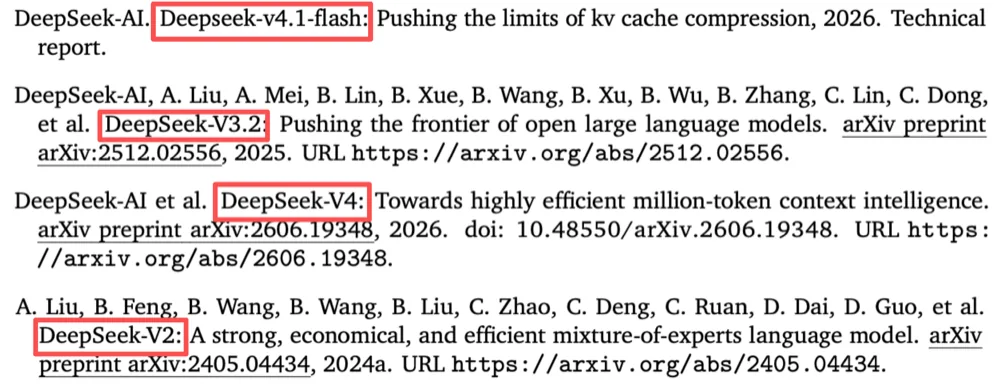
HySparse2论文由小米LLM-Core团队完成,引用了4项DeepSeek相关成果:DeepSeek-V2、DeepSeek-V3.2、DeepSeek-V4和DeepSeek-V4.1-Flash;此外还参考了OpenAI的gpt-oss模型卡及GPT-4.1相关评测工作。显示出小米在构建技术参考体系时的开放性。
落地建议
- 适合 quem:需要部署长上下文Agent的应用场景,尤其是对推理延迟和显存占用敏感的团队。企业自建Agent系统若面临多轮工具调用导致的上下文膨胀问题,HySparse2架构思路值得跟进。
- 该等等:普通开发者暂不建议急于升级。MiMo-V3尚未正式发布,当前的具体模型参数、开源计划及实际性能表现仍待官方确认;如对稳定性要求极高,可等待V3正式版发布后评估。
写在最后
从MiMo-V2.6的大规模RL训练到MiMo-V3的底层架构创新,小米展现出Fast-Follow+自主创新的双轨策略。HySparse2的价值不仅在于数字提升,更在于验证了稀疏注意力与KV共享结合的可行性,为后续轻量化Agent模型铺平了技术路径。