
核心事件
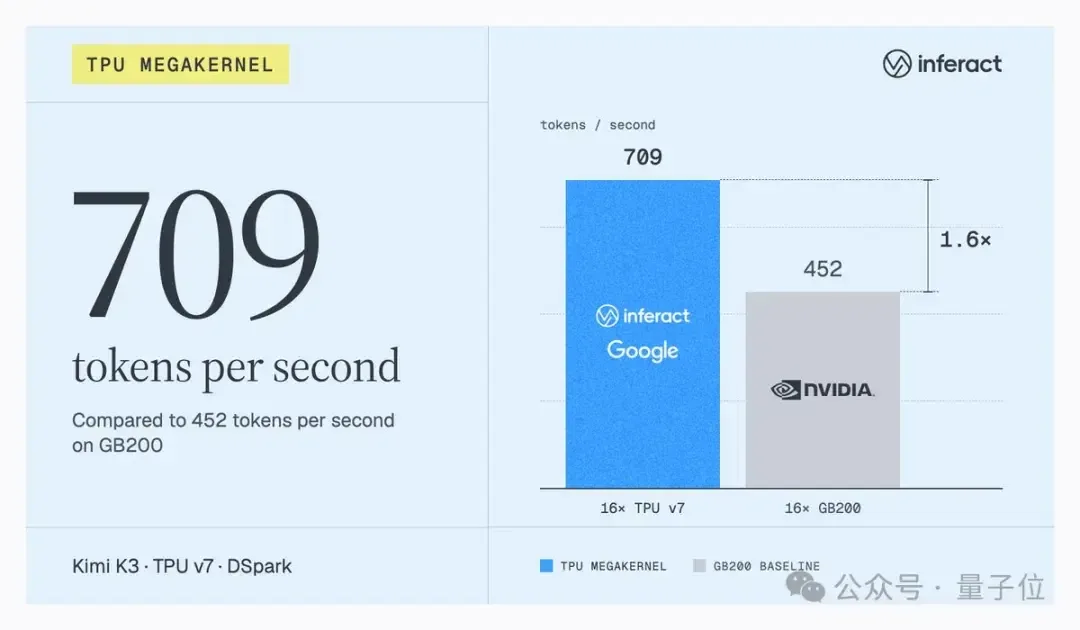
Inferact公司于2026年9月公开其TPU推理优化成果:在16块TPU v7 Ironwood上运行Kimi K3模型,达到每秒709个token,比16块英伟达GB200的452 token快57%。该性能是在使用相同vLLM推理引擎和DSpark推测解码框架的公平条件下测得。
- 实验平台:16块TPU v7 Ironwood vs 16块GB200
- 推理框架:vLLM + DeepSeek DSpark
- 模型:Kimi K3、Qwen 3.8 27B
- 开源状态:代码已开源(tpu-megakernels仓库)
- 商业背景:公司成立于2025年11月,a16z领投1.5亿美元种子轮,估值8亿美元
技术突破:megakernel如何撕掉kernel边界
Inferact创始团队来自vLLM原班人马,其核心创新是megakernel技术——将模型推理中原本需要调度的数百个独立小kernel合并为单一大程序。
传统推理流程中,每层计算完成后需等待下一层启动,造成内存带宽空转。英伟达通过CUDA Graphs和PDL技术可压缩此间隙,但kernel边界依然存在。Inferact的方案是用Google Pallas语言手写92层MoE结构的完整前向传播逻辑,一次调用走完全部计算流程。
TPU的硬件特性为此创造了便利条件:其TensorCore配备64 MiB VMEM片上内存,完全由软件管理生命周期。工程师可精确控制数据装载时机,使第N层计算时第N+1层权重已开始预取,实现计算与数据搬运并行。
注:megakernel指将多个微小计算单元融合为单一内核的技术,消除调度开销
意外数据:带宽更大却更慢
一项关键反差点在于硬件规格表:TPU v7的HBM带宽为7380 GB/s,而GB200反而更高,达8000 GB/s。带宽更大的GPU成绩却更低,说明性能差距主因在于软件层而非硬件。
性能基准对比
| 配置 | 模型 | TPU v7速度 | GB200速度 | 差距 |
|---|---|---|---|---|
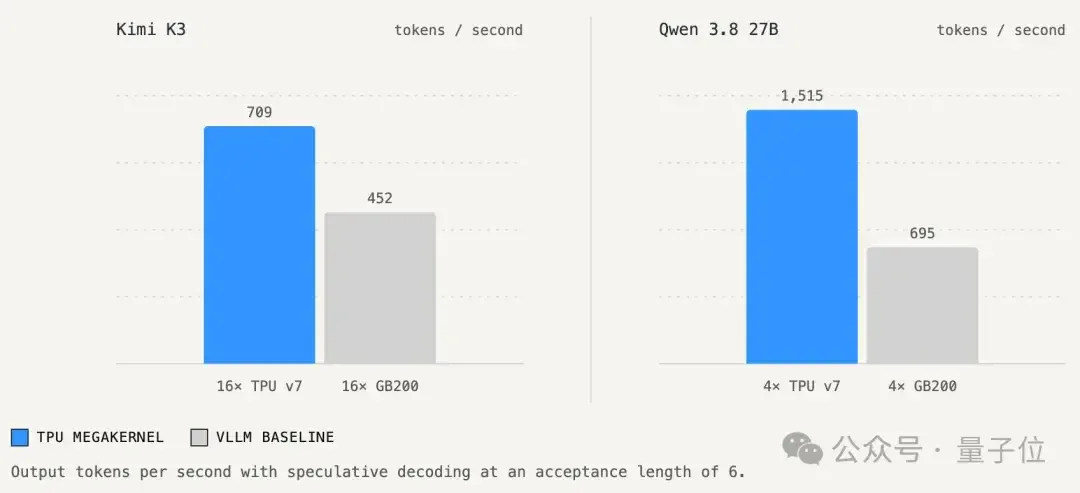
| 16芯片 | Kimi K3 | 709 token/s | 452 token/s | TPU快57% |
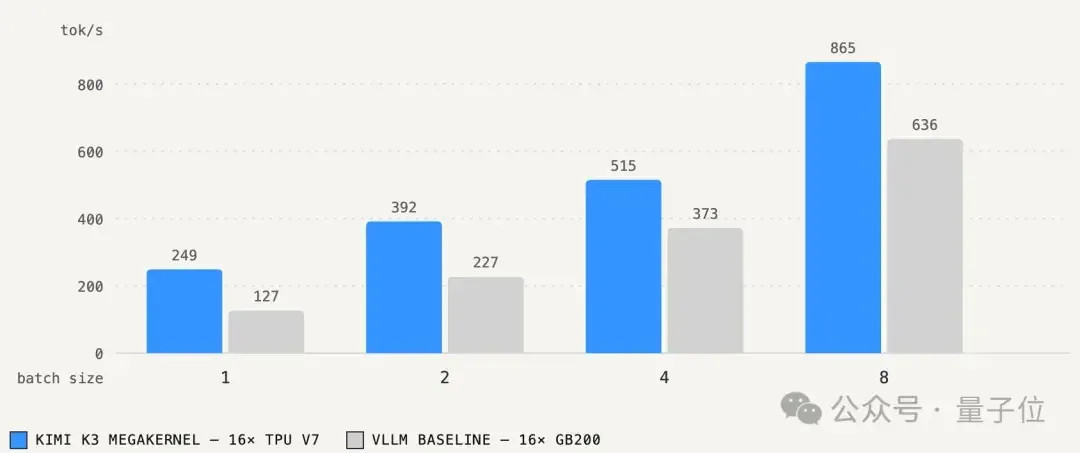
| 16芯片 | Kimi K3 (关推测解码) | 249 token/s (batch=1) | 127 token/s | TPU快96% |
| 16芯片 | Kimi K3 (关推测解码) | 865 token/s (batch=8) | 636 token/s | TPU快36% |
| 4芯片 | Qwen 3.8 27B | 1515 token/s | 695 token/s | TPU快118% |
DSpark推测解码在TPU上达成6的acceptance length,即平均每次验证6个候选token全部通过,单步decode耗时约8.5毫秒。
精度验证与落地建议
Inferact使用greedy decoding验证精度无损:Kimi K3在TPU上GPQA-Diamond得分为94.4%,GSM8K为97.2%,与GPU结果完全一致。
- 适合谁用:已有TPU基础设施或计划深度定制推理路径的模型服务提供商;需要批量高吞吐场景(如批处理推理)的团队
- 建议等等:追求通用模型兼容性的中小开发者(当前megakernel为Kimi K3定制,换架构需重新适配)
写在最后
这场性能反转揭示了AI基础设施的范式转移:软件栈对硬件潜力的释放程度,已超越硬件参数本身。当硬件规格趋同,软件优化的深度成为决胜关键。随着vLLM原班人马入局TPU生态,OpenXLA等自动工具链与手工megakernel的混合策略或将重塑推理框架竞争格局。