
事件速览:华为2026全联接大会发布全新AI算力底座
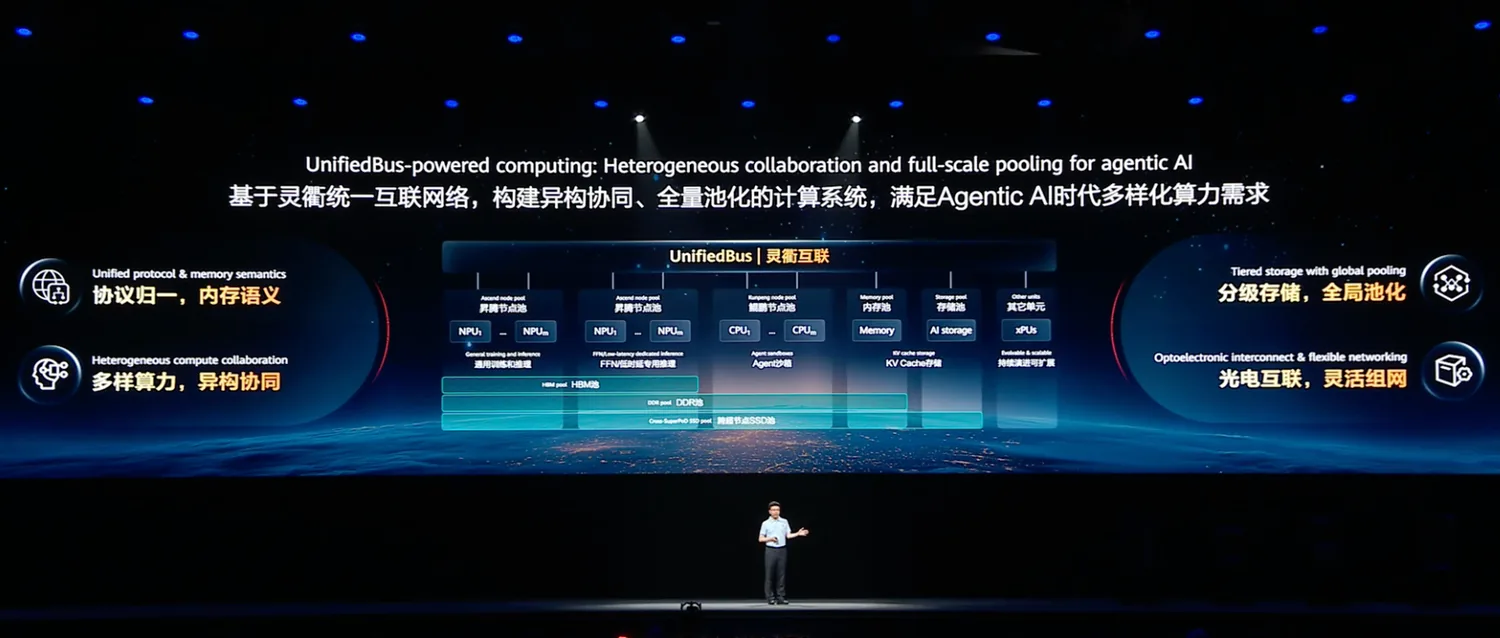
在2026年9月17日-19日举行的华为全联接大会上,华为正式发布基于灵衢(UnifiedBus)互联架构的系列AI基础设施新品,核心成果包括:
- 昇腾960芯片及超节点(风冷版2027年Q2上市,液冷版2027年Q3上市)
- OceanStor M900 AI记忆存储
- 鲲鹏950超节点
- 星河UBG交换机
- Atlas 650E双机直连一体机(支持本地万亿参数模型推理)
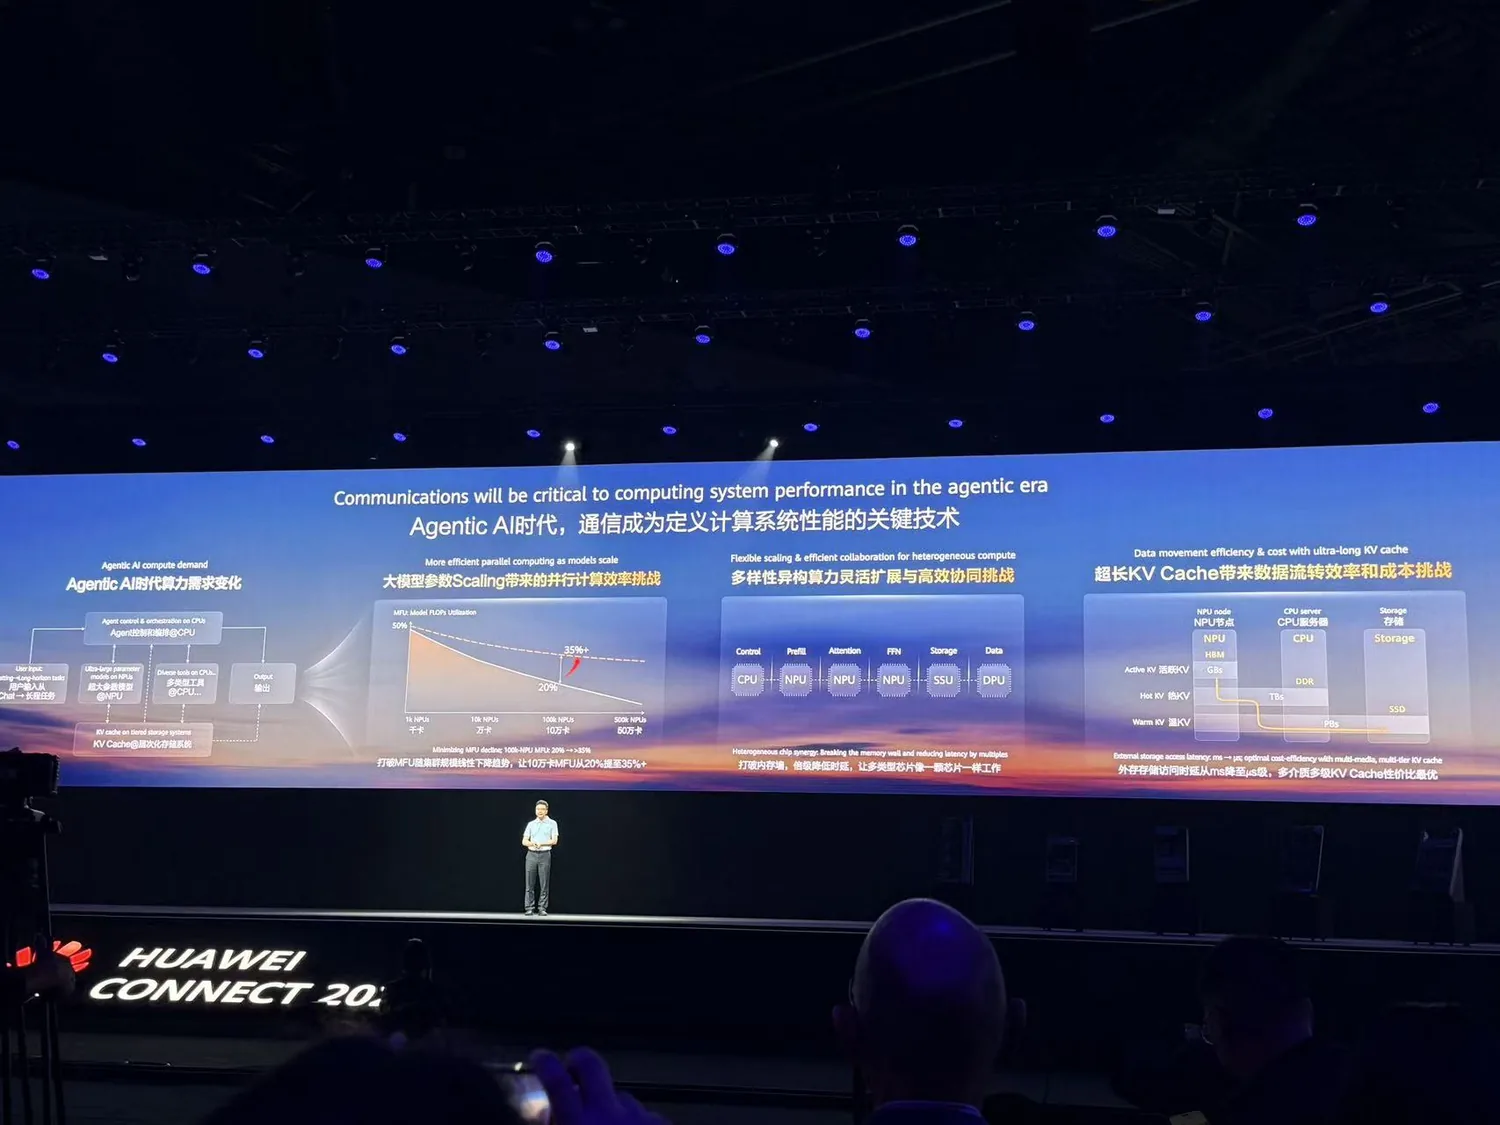
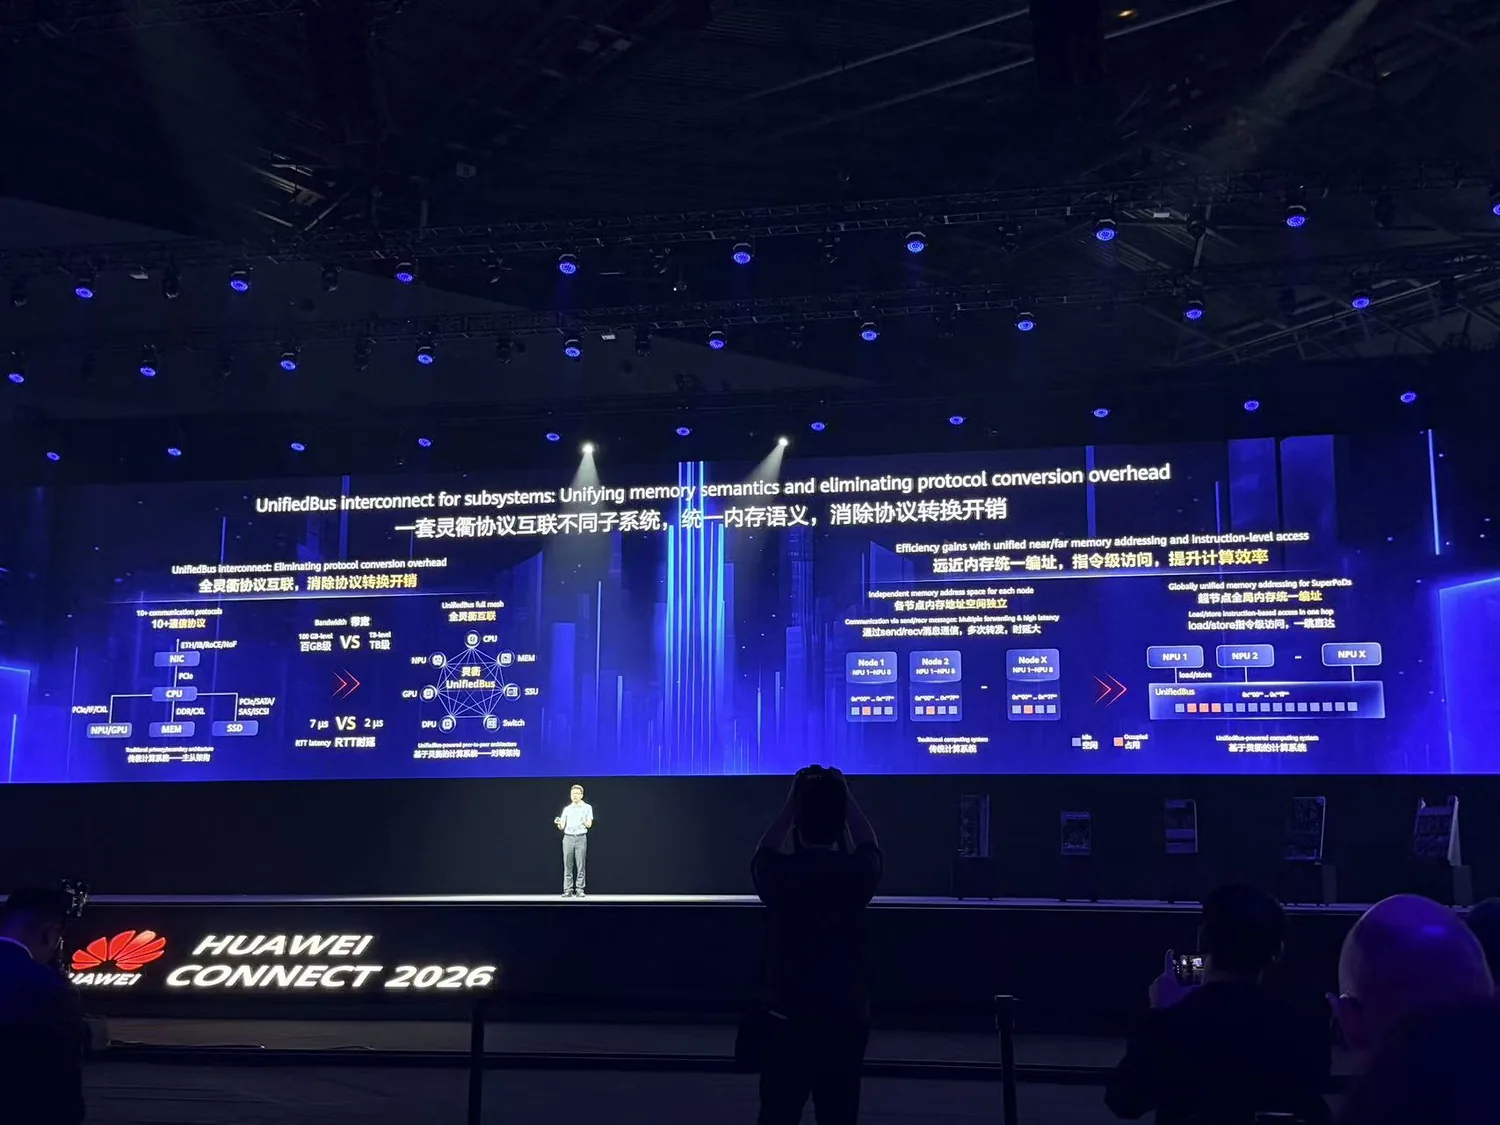
关键技术参数:单集群支持100万颗AI处理器;10万卡集群模型浮点算力利用率(MFU)从20%提升至35%;灵衢协议实现TB级互联带宽、2微秒RTT时延;昇腾960超节点最高提供8 EFLOPS FP8算力。
通信墙成瓶颈,灵衢架构直击三大痛点
传统基于PCIe加RoCE的互联体系在AI Agent时代面临严峻挑战:模型参数向50万亿级演进、上下文长度达几十M级,导致通信量平方级增长。关键反差点在于——当前十万卡集群的实际算力利用率仅约20%,远低于实际需求,通信时间占比成为性能天花板。
灵衢架构通过一套协议打通芯片到集群,实现四大突破:
- 协议归一:将CPU、NPU、DPU、DDR、SSD等十几种协议统一,消除协议转换开销;超节点内实现全局内存统一编址
- 异构协同:计算、存储单元对等互联,支持CPU/NPU动态配比与PD分离部署
- 分级存储池化:HBM/DDR/SSD多级缓存统一管理,单节点访问带宽达480GB/s
- 光电互联组网:物理传输距离超200米,单4096卡超节点节省196公里铜缆,单端口速率1.6T,整机280T全光互联
产业链观察指出,此前行业多在旧协议上修补,而灵衢相当于重装底层通信逻辑,满足多样化算力协同需求。
产品矩阵:从百万卡集群到桌面级一体机全覆盖
基于灵衢的超节点集群形成完整产品谱系:
- 大规模部署:鲲鹏950超节点单柜支持12288个CPU核、192TB内存;昇腾960超节点支持8颗NPU、32 PFLOPS FP4算力;星河UBG交换机单机支持1024 Radix扇出,单集群可拓展至百万卡规模
- 中规模节点:4096卡超节点由56个计算柜与14个灵衢互联柜组成,系统可用度达99.8%
- 轻量化落地:Atlas 650E双机直连支持16 NPU Full-Mesh组网,无需交换机;万亿参数模型推理吞吐提升40%以上,时延低至10毫秒;支持后续平滑扩容至小型超节点
算力产品关键参数对比
| 产品 | 核心配置 | 算力/容量 | 灵衢互联特性 |
|---|---|---|---|
| 昇腾960超节点 | 8颗昇腾960 NPU/刀片 | 32 PFLOPS FP4 / 8 EFLOPS FP8 | 4096卡单元/ATP带宽17.9TB/s |
| 鲲鹏950超节点 | 384 CPU核/刀片 / 单柜12288核 | 24000TB内存池化 | 统一调度超150万核 |
| OceanStor M900 | 三芯合一存储控制器 + ASU模组 | 单ASU 64TB / 单节点480GB/s | 与计算单元全局池化访问 |
| Atlas 650E | 最高8卡一体机 / 双机直连16 NPU | 万亿模型本地推理时延10ms | Full-Mesh无交换机互联 |
落地建议:按场景选择演进路径
- 适合优先采用:垂直场景(电力巡检、金融风控等)有本地部署需求的企业,可选用Atlas 650E双机方案快速验证;需千万卡级大模型推理的云服务商,可关注2027年Q3上市的液冷超节点
- 建议再观望:单卡或小规模(≤4卡)场景当前仍有成熟PCIe方案性价比更高;对FP4精度敏感且需长期训练的任务,需等待社区算子库完善(当前已打造26个行业专属算子库)
写在最后
华为以"计算+通信"垂直整合能力切入算力基础设施深水区,验证了Agentic AI时代通信架构的决定性价值——当模型规模逼近物理极限,打破通信墙才能真正释放算力红利。