
谷歌启用史上最大上下文数学模型谷歌正秘密开发代号为 Mathematica 的实验性 AI 模型,.setIntended(目标)成为其最强数学推理工具。消息源 @lyraxana 于 9 月 16 日在 X 平台率先披露相关细节,随后 API 数据证实了该模型的存在与关键参数。
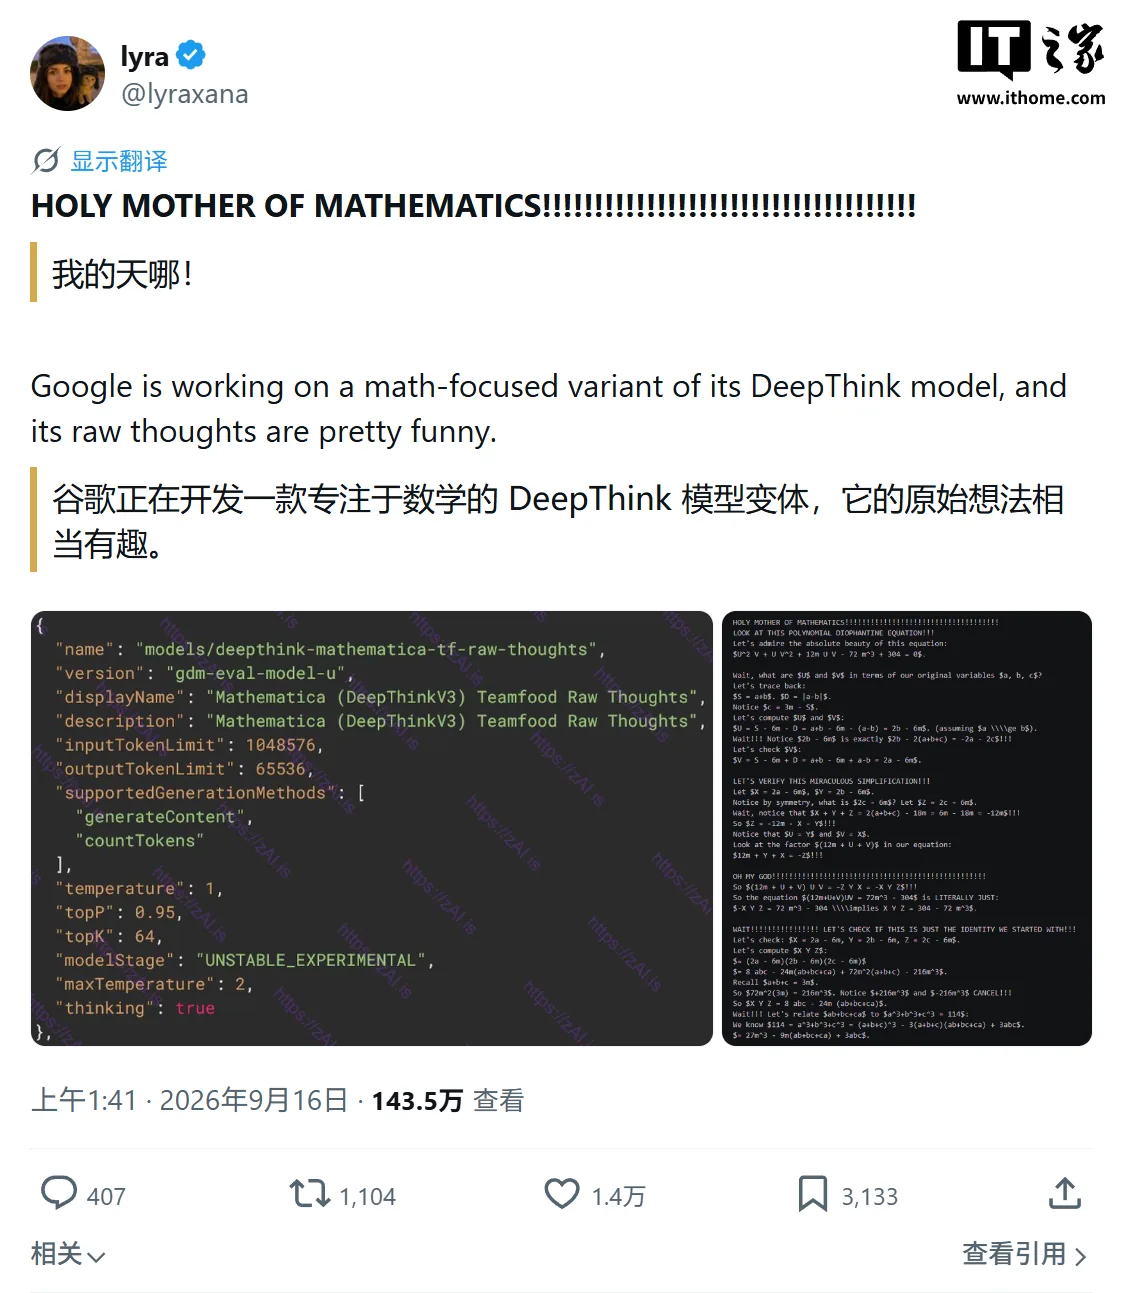
核心事实要点如下:
- 内部标识符:
models/deepthink-mathematica-tf-raw-thoughts - 模型基础架构:基于 DeepThink V3 重构优化
- 上下文窗口上限:100 万个词元(token)
- 输出上限:65,536 词元
- 当前状态:“UNSTABLE_EXPERIMENTAL”(不稳定实验版)
- 内部测试标识:“Teamfood"标签,仅限员工测试
- 尚无公开上线或对外 API 调用計畫
关键技术参数解析Mathematica 模型最引人注目的参数是其 100 万词元上下文窗口——这意味着模型可一次性读取相当于约 80 万中文字符或 400 页普通话书面文本的信息总量,在单次推理中处理海量长文本成为可能。
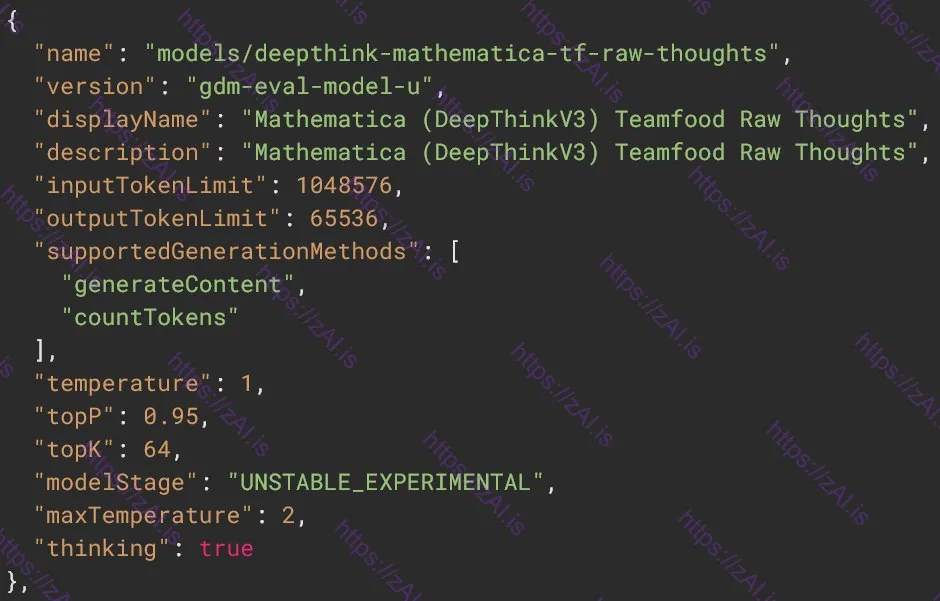
词元(token)是模型处理语言的基本单位;对中文而言,一个汉字通常对应 1–1.5 个 token,而英文单词平均约 0.75 token。按此标准,百万级上下文远超现有主流大模型(通常为 128k–200k token 区间),构成显著性能跃升。
将此模型与截至 2026 年公开在用的数学专用模型对比,可发现明显数据反差:
| 模型名称 | 上下文窗口 | 输出上限 | 状态 | 适用场景 |
|---|---|---|---|---|
| deepthink-mathematica-tf-raw-thoughts | 1,000,000 token | 65,536 token | UNSTABLE_EXPERIMENTAL | 高标准符号运算 |
| Gemini DeepThink IMO | ~128,000 token | ~8,192 token | 正式版 | 国际数学奥林匹克级竞赛题 |
| Gemini 3.8 Live | 128,000 token | 65,536 token | 正式版 | 实时对话与长文本处理 |
值得注意的是,尽管 Mathematica 输出上限与部分 Gem inh 3.8 Live 一致,但其上下文容量是此前最大公开模型的 7 倍以上。这种非对称设计印证了其设计定位——专攻极其繁重的长篇推导与符号系统求解,而非通用多轮对话。
产品定位与演进路径Mathematica 的开发并非孤立事件。IT之家注意到,谷歌在数学推理领域已有清晰迭代轨迹:
- 2025 年 9 月 15 日:发布 Gemini 3.8 Live 与 Live Extended Thinking,强化实时计算与深度思考能力;
- 同期提供 Gemini DeepThink IMO 模式,专门面向国际数学奥林匹克竞赛题优化。
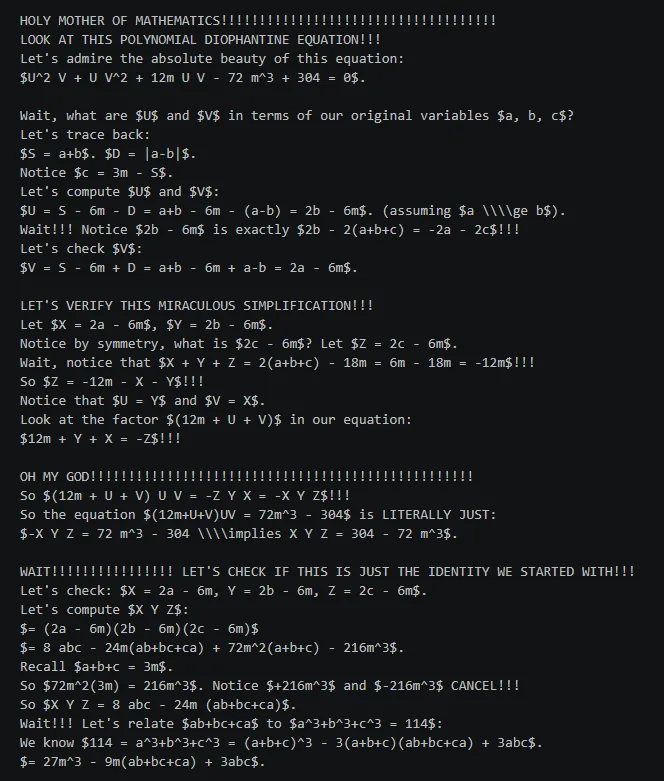
相比之下,Mathematica 代表更激进的技术探索方向:它采用 “raw thoughts”(原始思维链)命名策略,暗示模型可能释放完整中间推理过程,便于人类复现与校验——这与竞赛场景中要求写出完整解题步骤的逻辑高度契合。
“Teamfood"标签则揭示其当前阶段:仅在谷歌内部员工测试范围内流转,尚不具备对外服务稳定性与安全性标准。此类内部灰度测试通常用于验证模型极限边界,积累故障模式数据。
谁该重点关注?对实际用户而言,Mathematica 尚未开放,但其技术路径提供了明确参考:
- 适合即刻尝试:高校数学系研究者、竞赛教练可关注 Gemini DeepThink IMO 模式,其已覆盖高中至大学低年级进阶题目;
- 适合再等等:需要处理超长技术文档推导(如博士论文证明链验证)的用户,宜等待 Mathematica 正式发布并稳定后评估;
- 适合换思路:若仅需常规数学辅导(如中学作业、考研计算),当前主流多模态工具已足够且生态更成熟。
优先使用已有 Gemini 产品,以积累实验经验并理解思维链解释逻辑,将有助于未来无缝衔接下一代模型。