
Figure AI 发布 Helix 2.5:机器人进入真实家庭的首次大规模测试
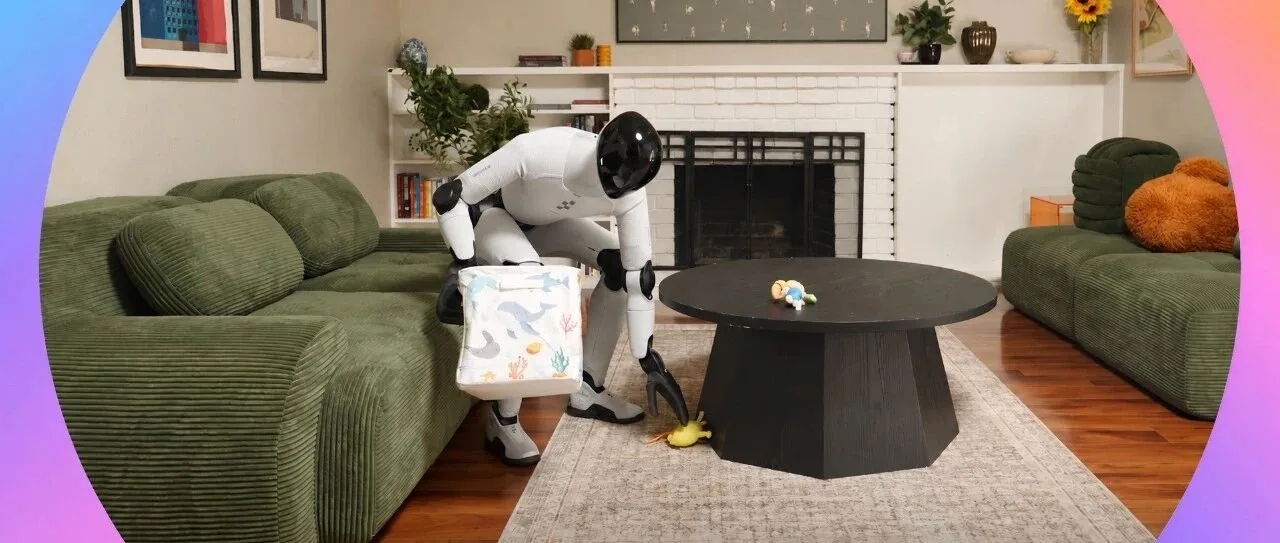
- 发布时间:2026年9月(具体日期未披露,基于新闻发布时间推断)
- 新版本:Helix 2.5
- 测试环境:旧金山湾区 30 套真实住宅(此前未采集数据)
- 测试任务:整理客厅(13-15件玩具入篮)、折叠毛巾(4条全部折好)、铺床(满足位置/方向/覆盖要求)
- 测试次数:总计 420 次,每项任务各 140 次
- 核心数据:完整任务成功率 56%(237/420);铺床 67%、折叠毛巾 62%、整理玩具 40%
- 零样本能力:模型未针对住宅或物品进行微调,使用固定版本完成全部测试
Zero-shot 与泛化能力:声明与质疑的两极
Helix 2.5 的技术突破在于学习范式的改变。此前的 Helix 02 依赖特定环境的机器人数据,训练后难以迁移;Helix 2.5 则先在 Figure AI 的人类行为数据集 Index 上进行预训练,再针对三项家庭任务分别微调。关键进步在于:测试时未对住宅布局或具体物品(如毛巾材质、床高、玩具摆放)进行任何适配或再训练,实现了真正意义上的零样本迁移——机器人被送入从未进入的房屋,处理从未见过的物品组合。
Figure AI 称此为「人类到机器人迁移 scaling law」的首次实证。实验显示,当 Index 预训练数据量从 1 倍增至 8 倍时,动作预测误差稳定下降;对照组数据中,无 Index 预训练模型仅 9% 成功率,而 Helix 2.5 达 56%。
与声明形成反差的是可靠性问题。Sunday Robotics 联合创始人 Tony Zhao(ACT/ALOHA 系统作者)指出:「有用的工作=泛化+可靠性」。Helix 2.5 近半失败(183/420)使其难以实际部署。Sunday 的 ACT-2 在衣物折叠测试中达到 99.1% 成功率(778/785),但其测试对象为单件衣物,而 Figure AI 的毛巾任务需连续处理四条并全部入篮,任务复杂度不同。
Stealth 创始人 Nikolai Ensslen 的批评更直指技术路线:「泛化意味着每次都能工作,而 Helix 2.5 并未做到。」他认为 56% 成功率恰恰证明模仿学习系统无法真正泛化。
Scaling law:Figure AI 的赌注与行业分歧
Figure AI 现在开始讲述 scaling law 的故事——这一过去仅属于大语言模型的叙事。机器人领域长期缺乏可预测的进步路径:数据昂贵、场景多变、硬件异构,多数能力仍需针对新场景重建。
helix 2.5 技术博客宣称已测得人类到机器人的迁移 scaling law:数据、模型规模与算力可像 LLM 一样线性推动性能提升。若此成立,当前 56% 的失败率仅是规模不足,扩大 Index 数据(当前收集速度每秒约 35 分钟人类经验)、模型参数与算力即可持续提升。
为支撑此判断,Figure AI 已与 Nscale 签署 35 亿美元初始算力合作,目标部署最高 10 万块英伟达 Vera Rubin GPU;公司估值达 390 亿美元(全球最贵未上市人形机器人公司),已生产超 350 台 Figure 03,生产周期缩短至每小时一台。
| 指标 | Figure AI Helix 2.5 | Sunday Robotics ACT-2(对比参考) |
|---|---|---|
| 测试环境 | 30 套真实住宅(零样本) | 实验室可控环境 |
| 成功率 | 56%(237/420) | 99.1%(778/785) |
| 任务单元 | 住宅级完整任务(含多物品连续操作) | 单件衣物折叠 |
| 泛化方式 | zero-shot 家庭环境迁移 | task-specific 微调 |
| 数据规模 | Index 数据集多版本测试 | 未披露训练数据细节 |
普通用户该如何看待?
- 适合谁用 / 再等等:企业级采购者(如养老院、酒店服务部门)可关注其长期进展,但当前 56% 成功率尚不足以支撑家庭独立部署;普通消费者建议至少等待 70%+ 成功率(连续任务失败率降至 30% 以下)再考虑试点项目。
- 开发者与研究人员:Helix 2.5 的零样本测试框架与公开数据为具身智能研究提供了有价值参照,可重点关注其 Index 数据集的开放进展。
写在最后
Helix 2.5 的真正意义不在于 56% 的数字本身,而在于它把机器人行业的讨论从「能否完成演示」推向「是否可依赖」的新阶段。如果 scaling law 在人形机器人上成立,56% 将是 strep towards 90% 的起点;若成功迹象停滞,那些接近 50% 的失败次数,便不再是规模问题,而是路线问题。