
GPT-6 Astra登顶B站AI竞技场榜单,国产模型表现亮眼
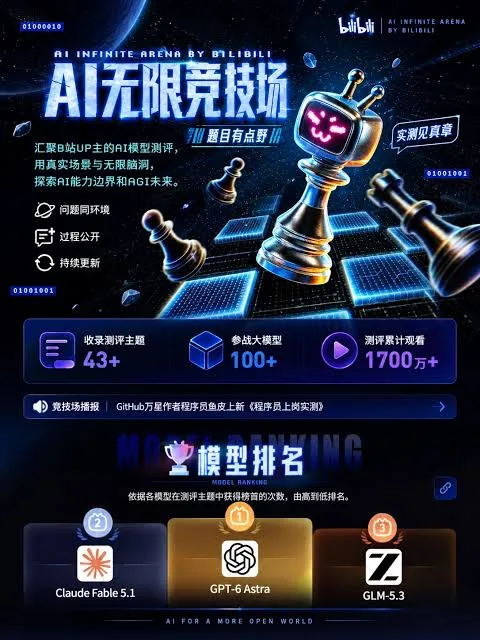
9月20日,B站正式上线"AI无限竞技场"大模型测评榜,并同步公布首轮模型排行榜。该测评体系由各领域UP主对上百个大模型进行真实场景实测构成,涵盖代码、推理、协作、知识等多种主题。
榜单核心信息包括:
- GPT-6 Astra在10位UP主测评中位列榜首,获得"榜首次数冠军"
- 前5名中,国产大模型占据3席,显示本土模型竞争力显著提升
- 榜单覆盖DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、千问、Hy、MiniMax等主流模型
不同于传统跑分评测,“AI无限竞技场"不设主题或测评维度限制,UP主们以真实工作流、专业应用、趣味脑洞等自主命题开展同题PK,直观呈现模型实际表现差异。榜单支持实时更新,并持续面向全站UP主开放报名。
真实场景测评模式获行业关注
B站的测评机制突破了传统AI评测依赖基准测试的局限。测评由UP主基于自身创作需求自主命题,例如编程任务中评估模型代码生成质量,推理任务中检验逻辑链完整性,协作任务中测试多轮对话的连贯性与准确性。
这种模式的优势在于:结果反映真实使用体验而非考试得分,避免了模型针对特定测试集的过拟合现象。以GPT-6 Astra为例,其榜首位置源于多位UP主在不同场景下的综合评价,而非单一技术指标领先。
值得注意的是,尽管榜单首名由GPT-6 Astra夺得,但国产模型整体表现可圈可点——多个模型在专业领域测评中展现特色:某些模型在中文创作任务中生成流畅度更高,另一些在代码理解和结构化数据处理上响应更精准。这种差异化优势构成国产模型突围路径。
测评体系开放性促进行业观察
“AI无限竞技场"的运营机制包含持续迭代特性:UP主可随时提交新测评内容,系统自动更新排名。这种设计使其成为观察大模型动态演进的实时窗口。
行业观察者指出,此类由社区驱动的测评体系正在补充专业机构评测的不足。当GPT-6 Astra等新模型快速迭代时,社区实测能捕捉到实验室数据之外的稳定性、兼容性等实际问题。
读者建议与落地参考
对于开发者:可参考榜单中具体任务分类的 TOP3 模型,结合自身项目需求做初步筛选。例如代码任务可关注评估表中代码生成相关排名。
对于企业采购决策者:建议将社区实测结果作为POC(概念验证)阶段的输入参考,但需结合自身业务场景补充定制化测试。
对于普通创作者:榜单提供了跨模型能力差异的直观对比,可据此选择适合自己的AI创作助手。
写在最后
B站AI无限竞技场的推出,标志着大模型评测开始从封闭的实验室评估转向公开的社区竞技场。这种模式既考验模型的真实能力,也倒逼测评体系保持客观性——毕竟在UP主们五花八门的自主命题面前,任何"纸面领先"都难以长期维持。未来若更多平台效仿此模式,行业对AI能力的认知或将更趋理性。