
核心事件:Arm 大规模升级 AI 计算布局
9 月 8 日,Arm 在上海 Arm Everywhere China 活动上发布新一代 AI 计算产品线,核心内容包括:
- CSS for Mobile 2:首个 AI 原生移动计算子系统,9 月 8 日发布,含 Arm C2 CPU cluster、Mali G2-Ultra NX GPU、SIL2 系统互连及开发工具
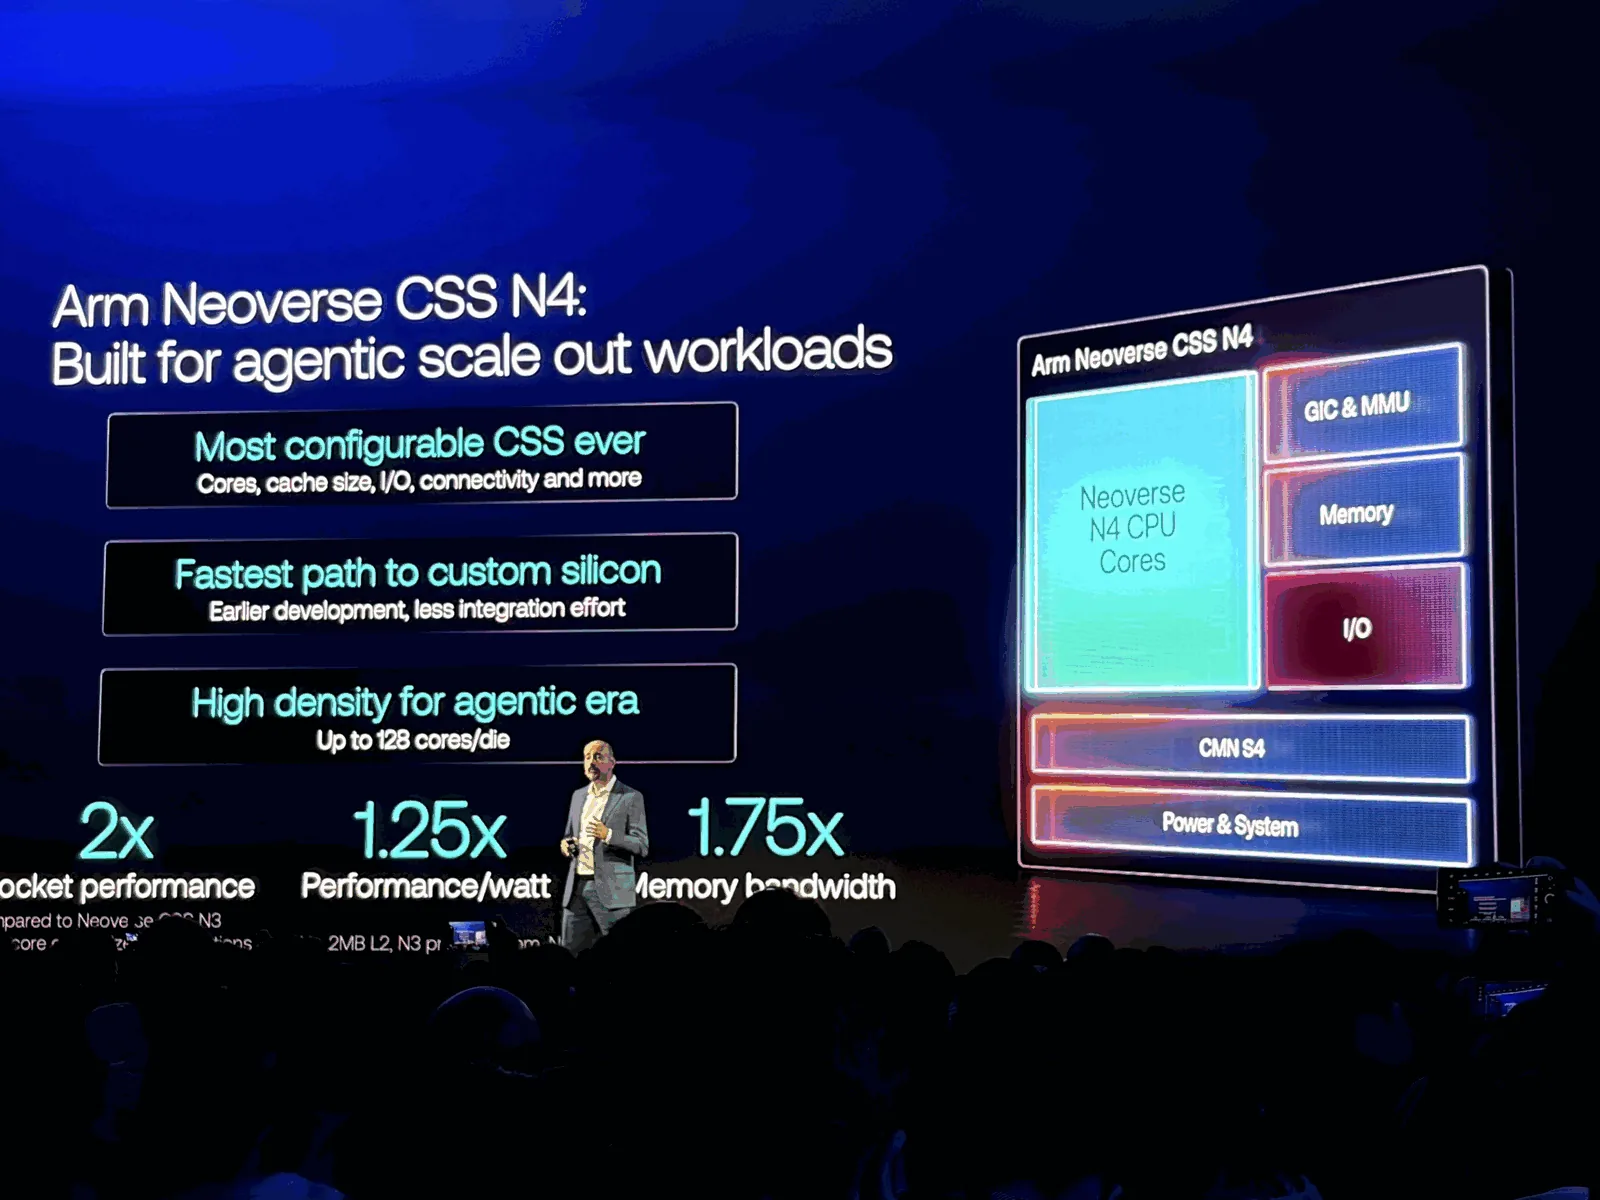
- Neoverse CSS N4:面向云侧的可配置型计算子系统,单裸片支持 128 核 CPU,支持 LPDDR6 与 PCIe Gen 7
- C2 CPU 集群:新推出的 CPU 集群,集成 SME2 单元
- Mali G2-Ultra NX GPU:首款集成神经网络加速器的 Mali GPU,加速器频率可达 GPU 时钟两倍
值得注意的是,Arm 不再仅提供 CPU IP 授权,而是转向提供包含硬件、软件与开发工具的完整平台能力。客户可按需选择 IP、CSS 子系统甚至完整芯片。
三大业务线:云、边缘与物理 AI 的协同计算
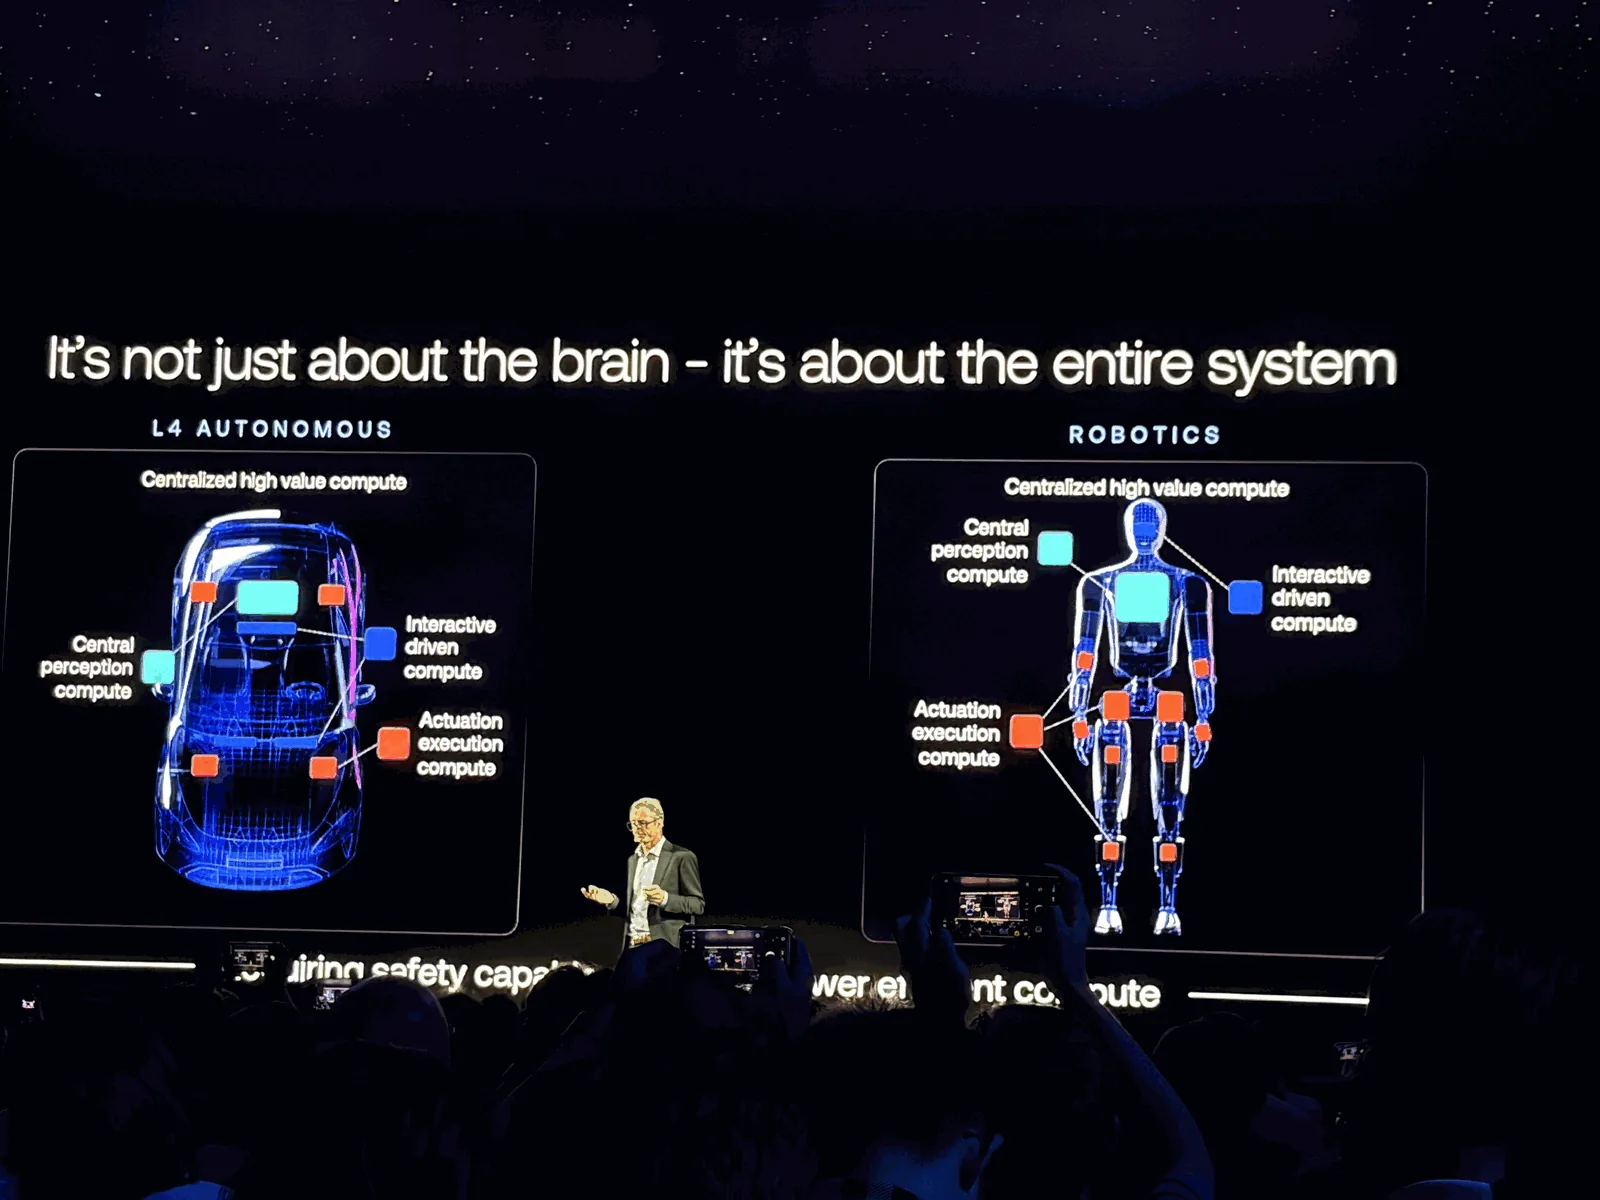
Arm 此次首次将未来方向明确拆分为云 AI、边缘 AI 和物理 AI 三条线,反映其对 AI 计算流动性的新理解:
- 边缘 AI:从「被动响应」转向「持续运行」,AI Agent 需在终端持续理解上下文、检索本地数据、调用应用并自主执行任务
- 物理 AI:业务重心从汽车拓展至机器人,共同特征是「感知到执行」的超低延迟要求
- 云端 AI:IDC 数据显示,基于 Arm 架构的机架级服务器市场规模已超越 x86,成为加速计算主流平台
反差数据在于性能表现:C2-Ultra 单线程提升 15%、多线程提升 12%,AI 负载性能最高提升 1.7 倍;但相同性能下功耗最高降低 38%——Arm 正从追求峰值算力转向能效与体验的综合优化。
| 平台 | 型号 | 关键升级点 | 性能/能力提升 |
|---|---|---|---|
| 计算子系统 | CSS for Mobile 2 | 首个 AI 原生移动子系统,含 C2 CPU cluster + Mali G2-Ultra NX GPU | 单线程最高+15%,多线程最高+12%,AI 模型性能最高+70% |
| 计算子系统 | Neoverse CSS N4 | 可配置性最高,支持 128 核,LPDDR6 与 PCIe Gen 7 | 插槽性能最高2倍,每瓦性能+25%,内存带宽+75% |
| CPU | C2-Ultra | 新推出的 CPU 集群,集成 SME2,共享 L3 缓存 | 单线程+15%,多线程+12%,AI 负载+70%,同性能功耗-38% |
| GPU | Mali G2-Ultra NX | 首款集成神经网络加速器的 Mali GPU,int8/int16 支持 | 神经加速器频率可达 GPU 2 倍,光追工作负载最高-70% |
产品逻辑:不替客户做决定,但让每种选择都跑得更好
Arm 的核心策略是拥抱不确定性,与英伟达、苹果等厂商形成鲜明对比:
- 英伟达通过 CUDA 构建封闭生态,锁定开发者于单一范式
- Arm 则提供开放底座,把调度权交给系统拥有者(OEM/芯片设计公司/软件开发者)
在具体产品中体现这一思路:
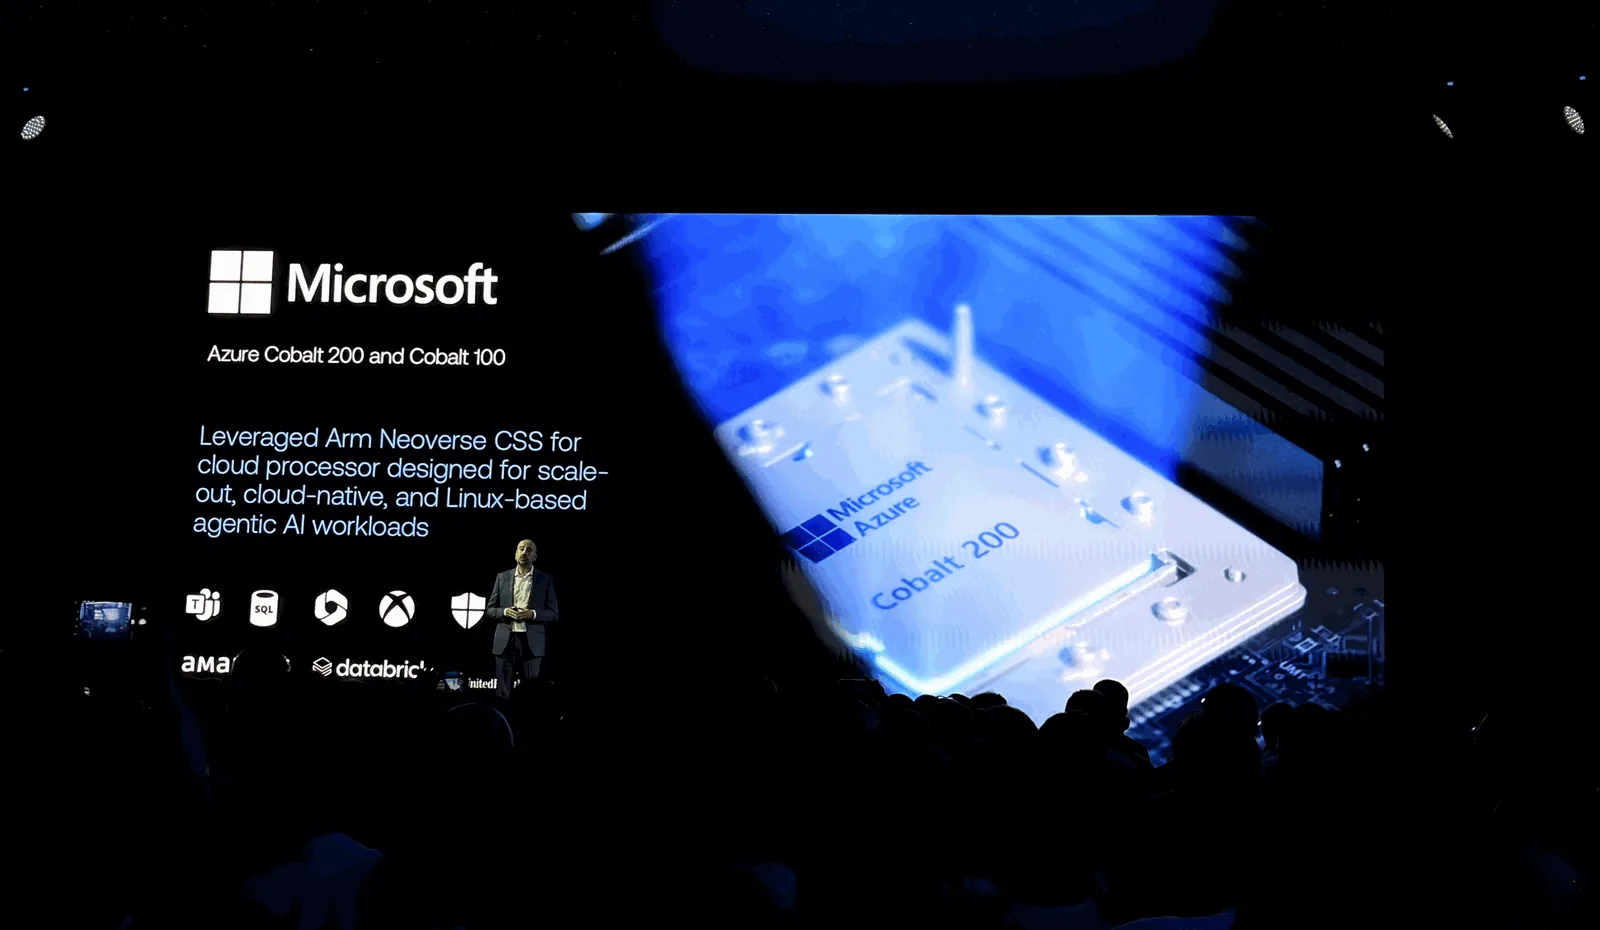
- CSS 模式:将分散 IP 组合成可调整平台,微软基于 Neoverse CSS 18 个月内完成两代 Cobalt CPU 交付
- SME2 指令集:通过指令集优化与软件生态建设,让 AI 能力在不同设备间快速迁移
- Mali G2-Ultra NX:神经网络加速器作为图形管线一部分参与调度,并开源模型至 Hugging Face/GitHub,支持开发者按需训练
Arm 不预设 CPU/GPU/NPU 的资源比例——此决策权交由芯片合作伙伴根据产品定位决定。
落地建议:面向开发者与 OEM 的选择指南
适合谁用:
- 需要快速构建 AI 终端产品的手机 SoC 厂商(可直接采用 CSS for Mobile 2 缩短设计周期)
- 云服务提供商寻求 Arm 架构服务器方案(Neoverse CSS N4 支持高密度、高能效部署)
- 开发者可利用优化后的软件工具快速迁移模型至 Arm 平台生态
建议再等等:
- 若产品定位高度依赖特定 NPU 架构或封闭调度框架(如 CUDA),短期仍需评估迁移成本
- GPU 神经图形功能需游戏厂商配合优化,成熟度将随 Hugging Face 社区模型积累逐步提升
写在最后
Arm 的转变揭示 AI 计算新范式:决赛 not about compute power alone, but about orchestration. 拥抱不确定性、构建可适配底座,或许比预设唯一未来更契合当下技术演进节奏。当算力在云、边、端之间自由流动,谁能提供灵活的协同标准,谁就可能成为 AI 时代真正的基础设施提供者。