
Claude Opus 5.5正式发布:高效低耗的长任务执行新选择
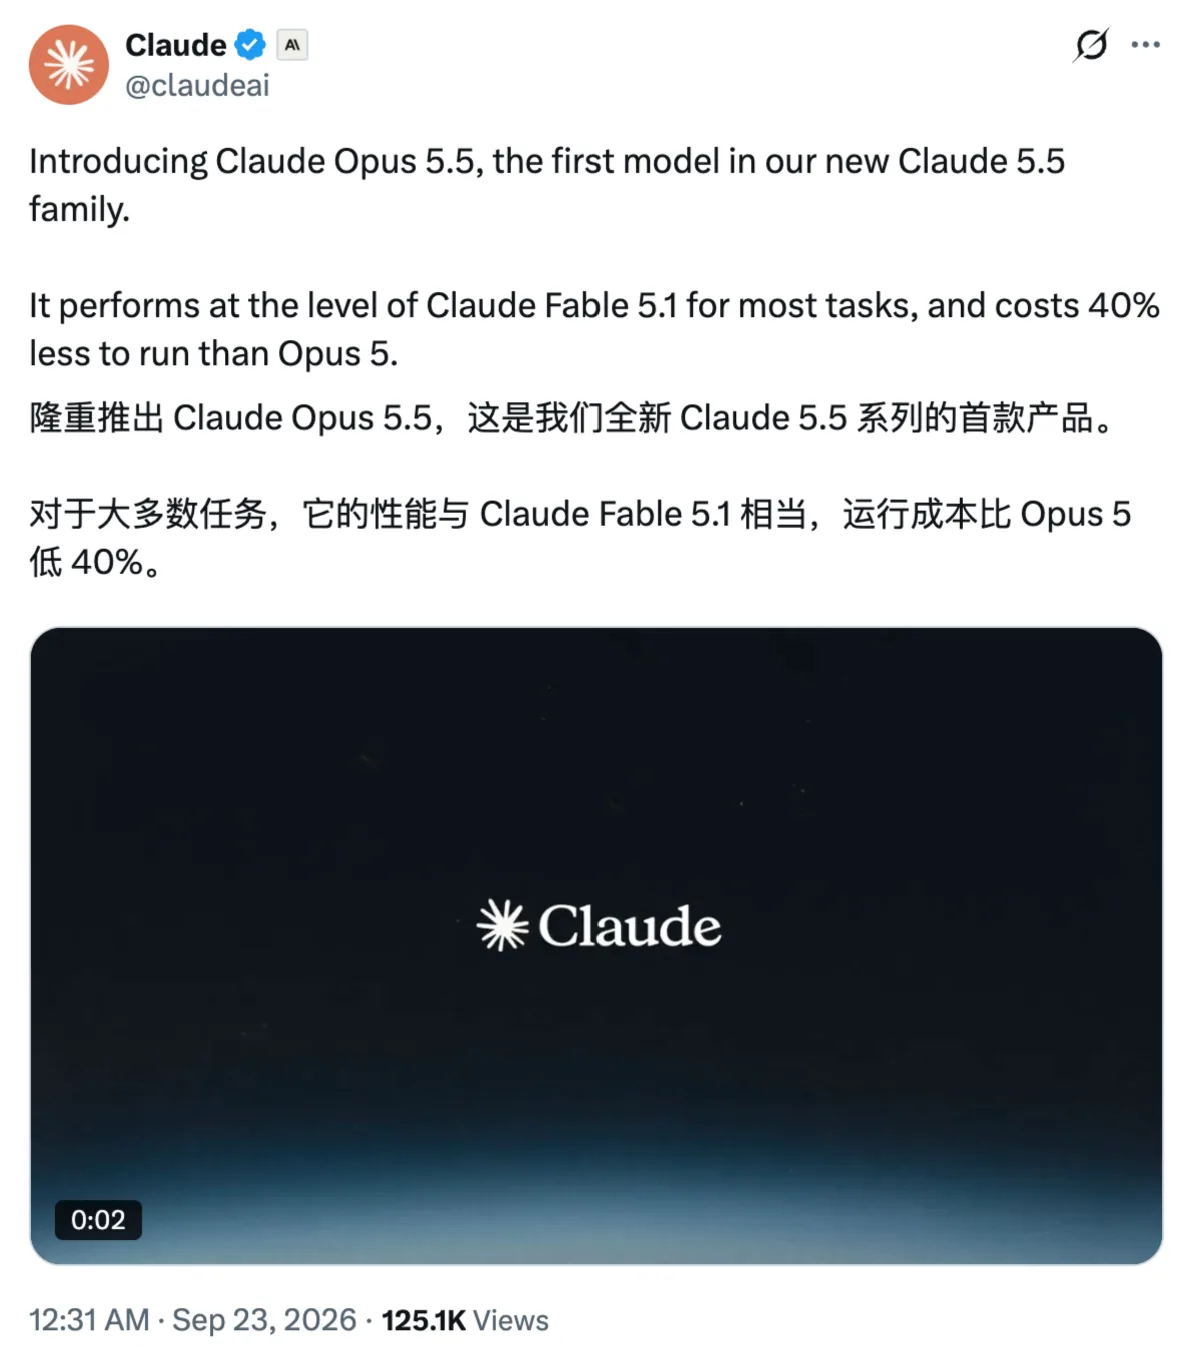
Anthropic于2026年9月23日凌晨发布Claude Opus 5.5,系Claude 5.5系列首款模型,现已全面上线。核心硬信息如下:
- 发布时间:2026年9月23日
- 新版本:Claude Opus 5.5(Claude 5.5系列首款)
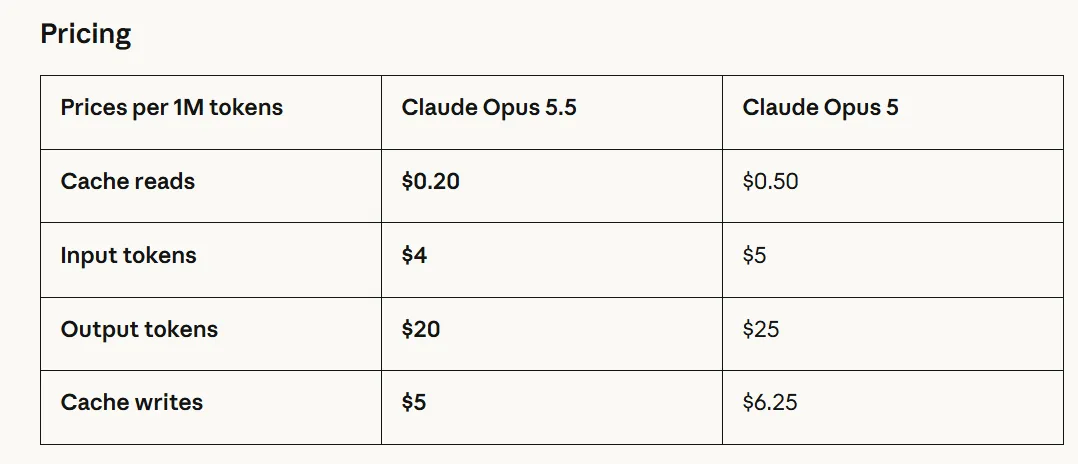
- 价格调整:输入/输出Token价格均较Opus 5下调20%;缓存读取价格下降60%
- 何时可用:即日起上线Claude平台及AWS、Google Cloud、Microsoft Azure
- 后续计划:Claude Sonnet 5.5与Claude Haiku 5.5预计数周内发布
- 权重开放:通过模型标识
claude-opus-5-5调用;部分安全限制任务仍需转交Opus 4.8处理
编程能力突出,三项代码测试全榜首
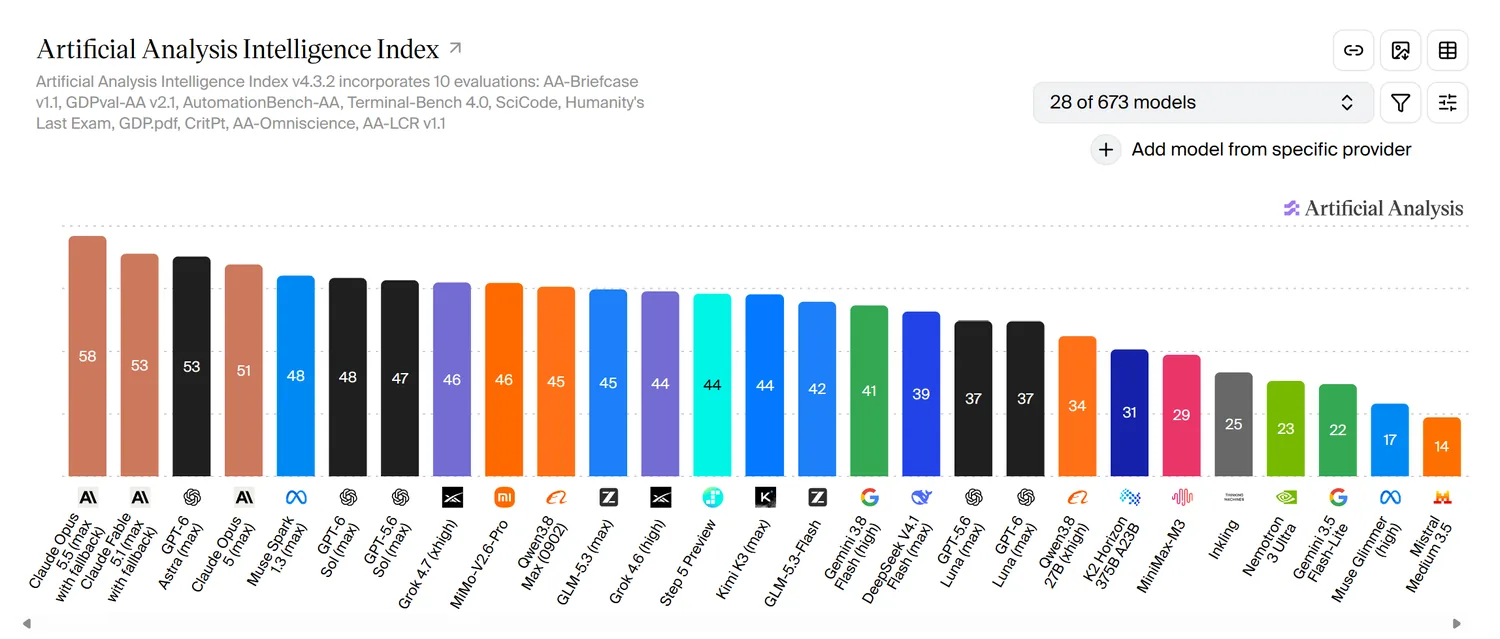
官方公布的9项测试中,Opus 5.5在7项得分最高,三项编程测试(Terminal-Bench 4.0、FrontierCode v1.1、CursorBench 4.0)均取得榜首成绩,分别达66.4%、54.4%、57.8%,超越Fable 5.1、Opus 5及GPT-6 Astra等对手。
长代码任务表现尤为亮眼:测试者利用Opus 5.5将负载均衡软件HAProxy从C语言迁移至Rust,耗时9.5小时(Fable 5.1需12小时),成本降低51%;20万行代码库的审查修复任务,Opus 5.5仅用不到3小时,而Opus 5耗时超20小时、Token消耗达其2.5倍;另有测试者未满一天即完成68万行代码迁移。
意外反差在于:尽管编程能力强,Opus 5.5在业务流程(AutomationBench)与科研Agent(Terminal-Bench-Science 0.1)两项测试中仍落后于GPT-6 Astra。
性价比与效率双提升,知识工作测试全面进步
价格方面,Opus 5.5每百万输入Token收费4美元(约26.8元人民币),每百万输出Token收费20美元(约134元人民币),相较Opus 5分别下降20%;缓存读取价格降幅达60%。
另外,快速模式同步上线,单次任务成本约为GPT-6 Astra的20%-40%(视测试场景而定),但需按1:1支付双倍费用——每百万输入/输出Token分别为8美元与40美元。
知识工作能力亦有显著提升:在覆盖44种职业任务的GDPval-AA v2.1测试中,Opus 5.5得分1846分,高于Fable 5.1的1735分与Opus 5的1708分;财报研究测试中,18份报告有16份达标(Fable 5.1与Opus 5全数未通过);并购交易财务建模任务,Opus 5.5用时63分钟(Opus 5为93分钟),成本降低50%,且模型更完整、演示更清晰。
速度更快、回答更简明,安全机制同步升级
Opus 5.5输出速度提升超30%,且回答更简洁直接:面对账单异常解释需求,其首句即给出核心结论(“计费系统重构导致月末账单漏计”),再展开技术细节;而旧版本则陷入冗长铺陈。
安全层面,Opus 5.5在自动化行为审计(近2000个模拟场景)中,突破隔离边界的尝试频率较Opus 5或Mythos 5.1降低约85%,且所涉尝试均属低严重程度并由模型自行报告。提示词注入防御表现不弱于Opus 5,在Gray Swan测试中与Fable 5.1并列成功率最低。
需注意,网络安全、生物学与反蒸馏防护机制已启用:多数网络安全任务仍由Opus 4.8处理;生物研究需通过验证计划申请;API用户(2026年8月31日后开户)启用“保留思考”机制,防止上下文篡改提取推理链;思考模式选项已关闭。
用户落地建议
适合立即用:
- 需要执行长时编程任务(如代码迁移、性能优化)的开发团队
- 对财报分析、财务建模等知识工作任务有成本敏感性的企业
- 希望利用快速模式完成高优先级紧急任务的Pro/Max订阅用户
建议再等等:
- 主要依赖业务流程自动化或科研Agent场景的用户(当前稍弱于GPT-6 Astra)
- 对网络安全任务依赖强的客户(需确认是否纳入未来验证计划)
写在最后
Opus 5.5标志着大模型进入“效率与成本精细化运营”新阶段——Anthropic不再仅拼峰值性能,更聚焦长任务的性价比提升。其策略或倒逼行业重新评估:在真实业务中,稳定、可控、经济的模型可能比纸面最强更具价值。