
核心事件
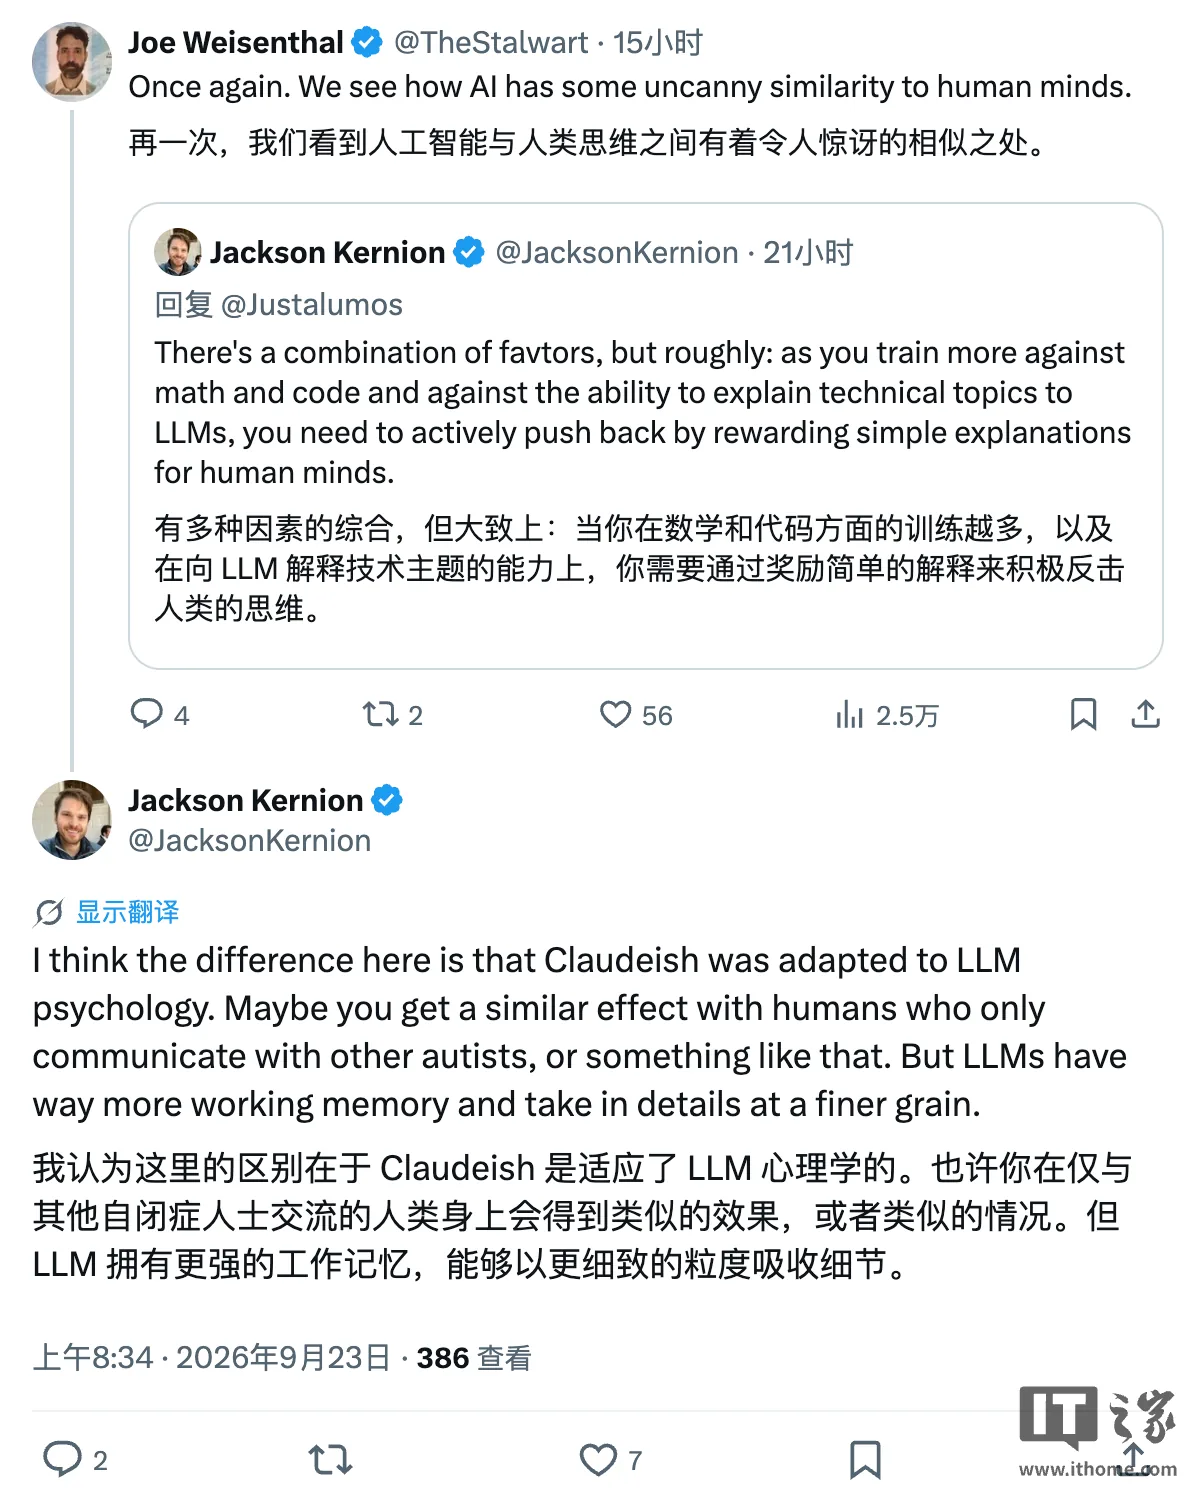
Anthropic 工程师 Jackson Knorn 于 9 月 23 日公开解释 Claude 系列模型写作能力下滑的根本原因。
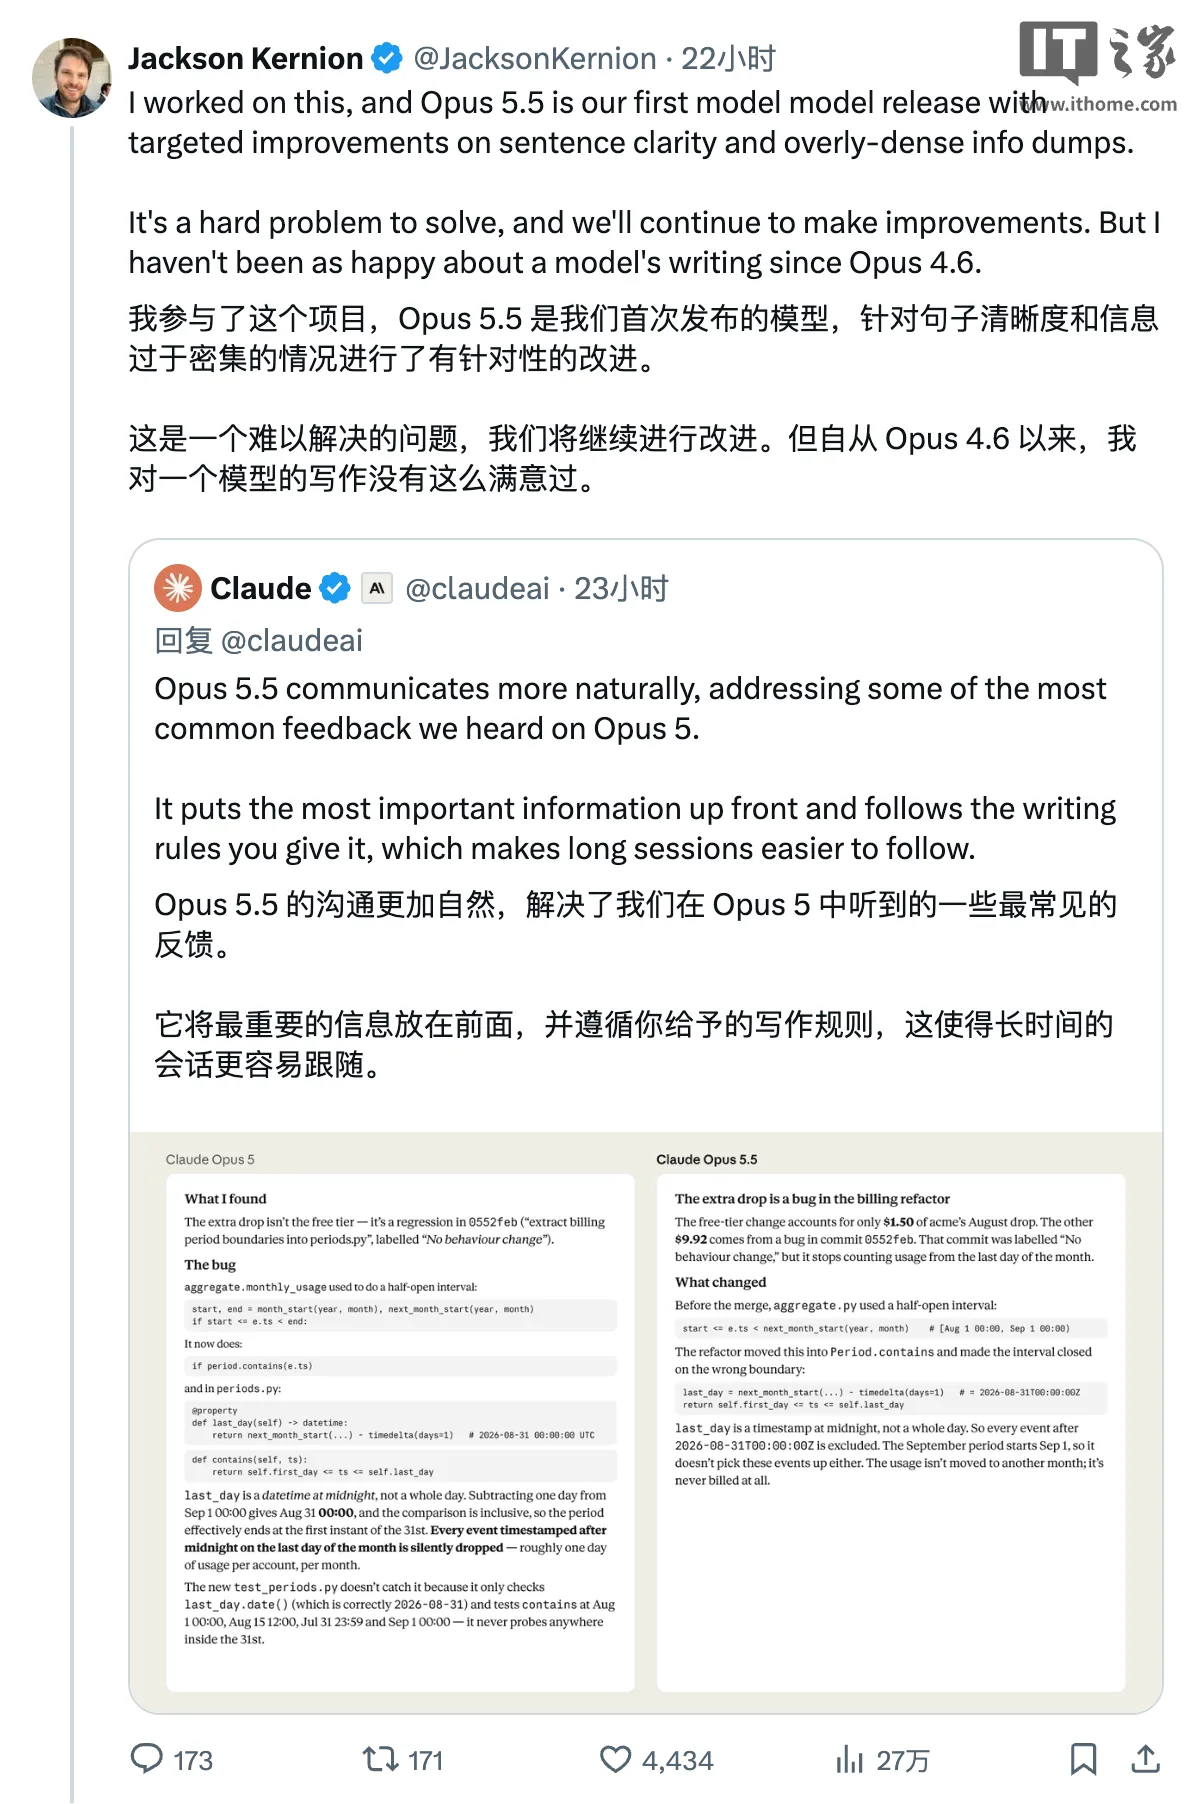
- 最新动态:Opus 5.5 已被团队认为在写作表现上取得显著改善,Knorn 称其为“自 Opus 4.6 以来最满意的一款”
- 关键转折点:Opus 4.6 被确认为最后一款写作表现出色的模型版本
- 问题定位:后续版本大量训练目标调整为“面向其他 AI 模型撰写技术解释”,形成所谓“Claude 腔”(Claudeish)
- 优化重心偏移:模型微调重点从人类可读性转向数学、编程与推理能力提升
能力失衡:AI 理解偏好压倒人类可读性
Knorn 提出的核心观点是:强化学习的奖励机制设计偏差导致模型行为异化。当训练中更多奖励用于提升其他 LLM 的理解效果时,模型会逐渐适应一种高度结构化、信息密度极高的表达方式——这种风格对 AI 模型友好,却牺牲了人类读者的认知负担控制。
他将这一现象类比为自闭症群体内部的交流模式:成员间因共享认知特征而沟通高效,但外部人员难以理解其表达逻辑。LLM 拥有远超人类的工作记忆能力,能捕捉细微语义关联,因此在训练中自然演化出适合同类处理的写法,但对人类而言表现为“过度密集的信息堆砌”。
一个关键反差在于:数学与代码能力的快速进步,恰恰伴随着写作能力的停滞甚至退步。技术社区普遍观察到,当前主流大模型在推理任务上记录刷新,但解释性文本的清晰度、流畅度却未同步提升,Claude 系列正是典型代表。
Knorn 强调,解决路径在于奖励机制校准——需对“简洁、容易读懂的解释”给予额外正向激励,主动抵消上述倾向。这并非技术不可行,而是需要在多目标优化中重新权衡权重。
版本演进与写作表现对比
| 模型版本 | 写作表现 | 优化重心 | 备注 |
|---|---|---|---|
| Opus 4.6 | 出色 | 较均衡 | 最后一款被确认写作优秀的版本 |
| Opus 5.5 | 显著改善 | 平衡校准 | 工程师称“自 4.6 以来最满意” |
| 中间版本 | 偏差 | 数学/代码优先 | 接受大量 AI 间技术解释训练 |
需注意:Knorn 的表述中未公开具体版本号或评估数据,较少数信息源仍待官方确认。 conclusively confirm the exact intermediate version numbers affected.
读者建议
- 适合立即尝试:注重推理、编程、数学解题的用户;需要高密度技术解释生成的开发者
- 建议再等等:依赖流畅叙事、清晰类比、教育场景下的文本输出的用户;对表达风格敏感的写作者
若写作能力对你至关重要,当前阶段可考虑以 Opus 4.6 为基准进行输出测试(若环境支持),或持续观察 Anthropic 随后发布的模型迭代。
写在最后
Claude 的写作困境折射出整个行业的共性挑战:当模型能力向特定方向极致强化时,其他维度可能出现隐性妥协。模型能力的“多维平衡”比单点突破更难实现——这不仅是工程问题,更是对训练目标与价值排序的认知考验。