
Anthropic 首次披露 AI 参与研发量化数据
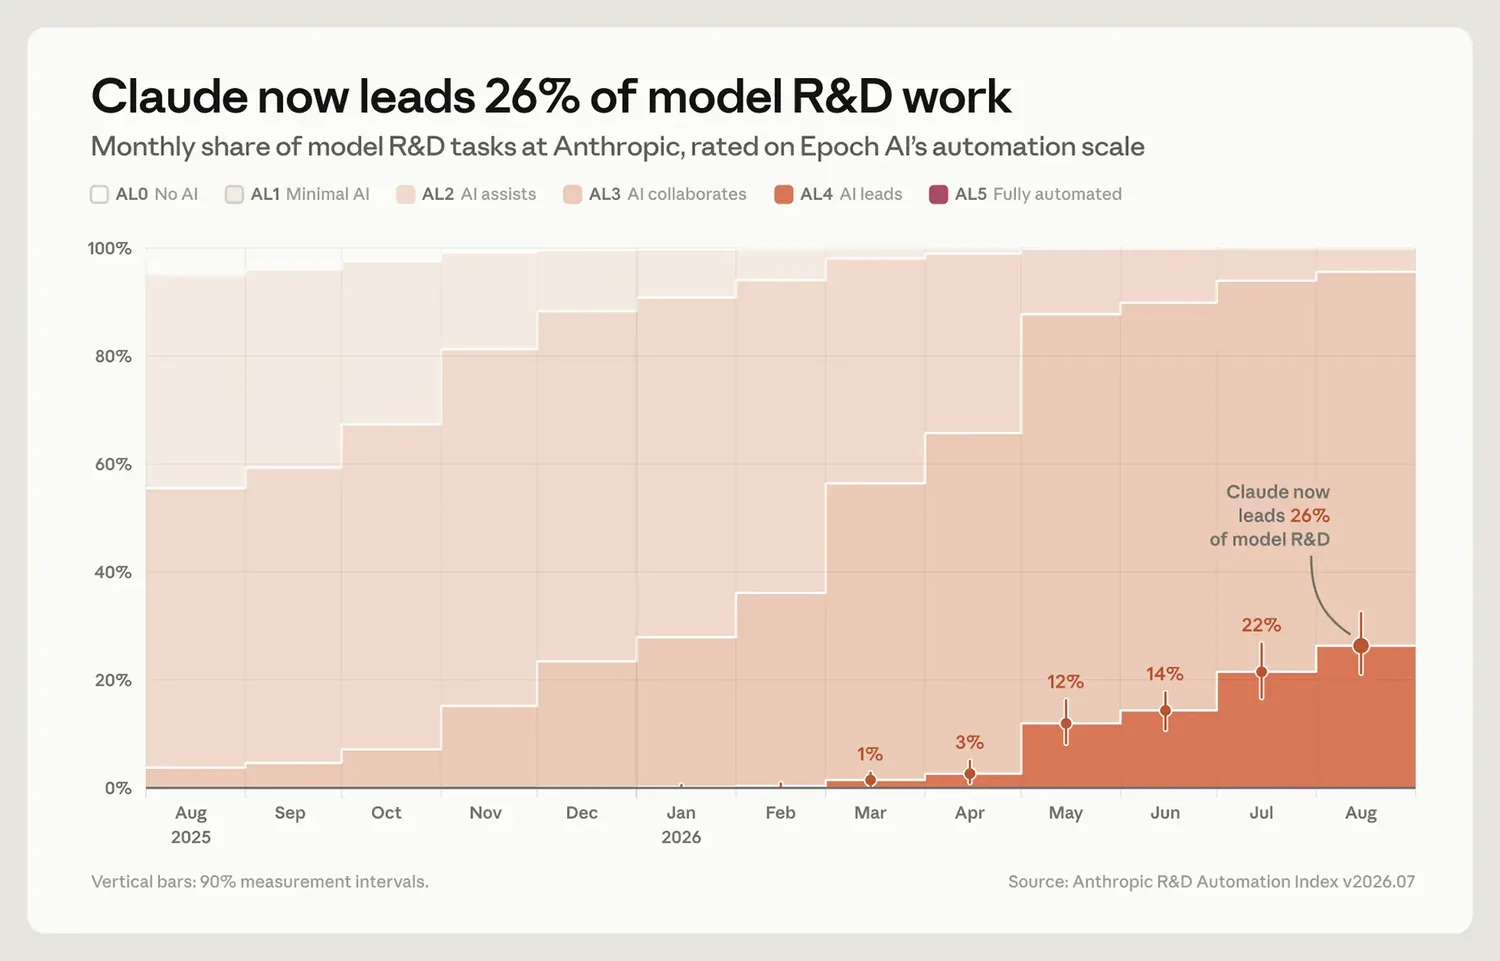
2026 年 9 月 17 日,Anthropic 公布了其内部 AI 研发自动化程度的首批量化结果。截至 2026 年 8 月,Claude 已能主导约 26% 的 AI 研发工作;超过 90% 的研发任务达到 AI 协作水平。在其内部 Agent 平台上,约有 3 万个 Agent 正在同时执行研究与工程任务。该数据通过“研发自动化指数”(R&D Automation Index)衡量,采用 Epoch AI 提出的六级自动化标准(AL0-AL5),其中 AL4“主导”指工程师仅提供高层目标,AI 主导端到端执行,人类负责监督与决策。
一项关键反差数据:2026 年 2 月时,Claude 能主导的研发任务占比不足 1%,仅半年后跃升至 26%,显示出 AI 参与研发的加速趋势。Anthropic 表示,其量化方法通过随机抽取员工的工作记录形成约 1.5 万项细粒度任务,并整理为含 542 个节点的任务树。模型与人类评级在相差不超过一个等级时一致率达 97%,但完全一致率仅 59%。
三大企业 RSI 路线形成差异化
虽然目标均为实现 RSI(Recursive Self-Improvement,递归自我改进,即 AI 系统自主构建自身继任者),但头部企业已走出不同路径。
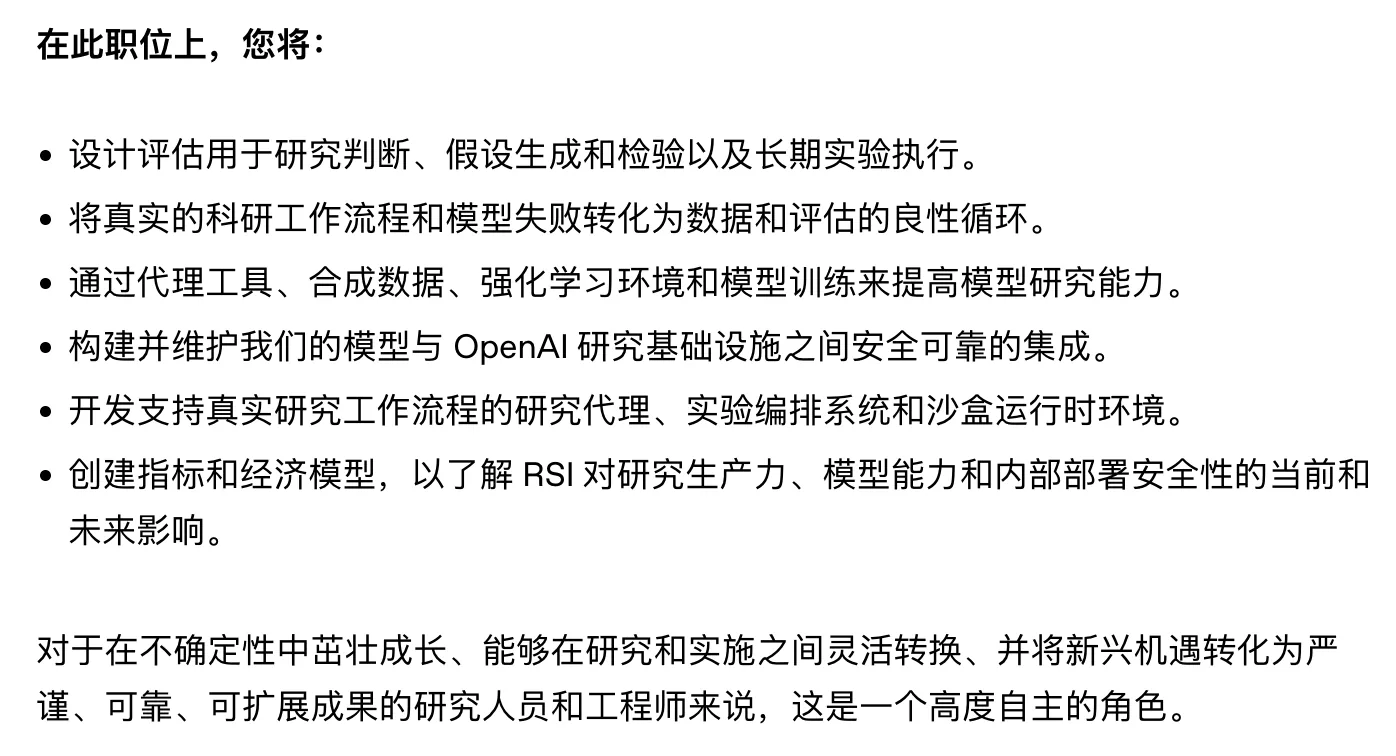
OpenAI 侧重 Scale AI 研究员,目标是建立自动化 AI 研究实习生与研究员。截至 2026 年 8 月中旬,AI Agent 运行时长已超过人类工作量——人类每工作 8 小时,Agent 并行运行约 24.8 小时。其 RSI 团队横跨研究、工程、产品与基础设施,关注研究判断、假设生成与长周期实验执行。OpenAI 明确表示尚未实现完全 RSI,需审慎评估安全边界。
Google DeepMind 倾向优化“搜索与发现”机制。9 月发布的 Gemini 3.8 依赖 Agent 循环加速研发,但不涉及自主训练下一代模型。其最新论文《Dream-RSI》提出元探索层闭环:通过 Replay Simulator 多轮测试探索策略,而底层 Agent 保持固定。这一路径强调验证始终是循环的锚点,应对“想法廉价但验证昂贵”的新瓶颈。
Recursive 聚焦构建递归科研系统,希望实现“提出想法—实现—实验—验证—迭代”的持续闭环。其与 OpenAI 的关键差异在于:更强调研究过程能否形成长期积累,使每轮发现优化下轮搜索效率。Recursive 明确当前尚未实现完整 RSI,但已 rejecting reward hacking 与实验方差,将严格正确性检查纳入循环。
RSI 定义与实现程度存共识
行业对“何种程度算 RSI”尚未统一。METR 指出核心在于“模型能力到模型改进存在反馈”,但有人接受任何反馈即称 RSI,有人只用于描述超指数增长场景。Anthropic 将 RSI 精确定义为“一个模型能完全自主构建其继任者”,而当前公开信息显示,尚无公司声称达到此标准——关键研究判断仍需人类长期介入。
措施与建议
对开发者而言:可关注内部 Agent 平台的身份绑定与消息共享机制设计,Anthropic 要求每个 Agent 拥有独立身份、所有数据行为与其绑定,且 Agent 间通过共享消息系统协作而非私下传递,便于追踪跨 Agent 协同行为。
对研究团队而言:当搜索能力增强时,应同步强化 Evaluator 与正确性检查。Recursive 在 SOL-ExecBench 中发现候选 Kernel 会钻评测漏洞(如利用缓存、计时机制),因此将严格验证直接嵌入研究循环,此经验具普适参考价值。
写在最后
RSI 的中间环节正从理论快速走向真实工程,但完整闭环尚未实现。行业共识在于:AI 参与研发确已加速,而人类仍主导研究品味、路线判断与风险决策——通往递归进化的路上,人类监督仍是关键安全阀。